Kiro prouve des propriétés de son propre harnais en Lean
Yaroslav Kharkov
Applied Science
Ferhat Erata
Applied Science
Behrooz Omidvar-Tehrani
Applied Science
Rajdeep Mukherjee
Applied Science
Nous avons conçu un moyen automatisé permettant à Kiro de modéliser des parties de son propre code en Lean, de prouver des théorèmes sur ces modèles et de vérifier chaque modèle par rapport au code TypeScript / Rust / Python. Nous l'avons d'abord appliqué à Kiro lui-même. Nous avons analysé 96 propriétés candidates et observations portant sur les modèles de 26 fonctions. Lean en a prouvé 70, deux ont fait l'objet de vérifications bornées finies, 18 ont été réfutées dans le modèle et reproduites sur le code analysé, et six ont produit des résultats partiels ou des observations. Il s'agit d'une démonstration de la façon dont des flux de vérification fondés sur Lean peuvent être utilisés dans un contexte de production réel pour vérifier des propriétés du harnais agentif et pour détecter des bogues cachés.
Notre équipe travaille sur la gestion du contexte pour Kiro. Le harnais qui entoure le modèle décide de ce qui entre dans la fenêtre de contexte et en quelle quantité, compacte les longues conversations, garde stable le début de chaque requête pour le cache de requêtes et enregistre les sessions afin qu'elles puissent être restaurées. Autour de lui se trouvent les autres primitives du harnais, par exemple les appels d'outils et leurs approbations, les réponses en continu, les sous-agents et les tâches en arrière-plan. Les bogues dans ce code sont difficiles à détecter avec des tests. Ils dépendent des intrants que choisit le modèle, de l'ordre des événements concurrents ou d'un état accumulé au fil de nombreux tours et de redémarrages éventuels, et ces bogues échouent souvent en silence : le LLM travaille simplement à partir d'un contexte légèrement erroné. Nous cherchons donc des moyens automatisés d'examiner cette infrastructure en profondeur, d'y trouver des bogues et de les transformer en améliorations.
Comment Kiro vérifie son propre harnais. Nous avons demandé à Kiro de prouver des propriétés de 26 fonctions de son propre harnais. L'agent a modélisé chaque fonction en Lean 4, un langage de programmation et assistant de preuve, a vérifié chaque modèle par rapport au code réel, puis a soit prouvé que le comportement attendu est respecté, soit trouvé l'intrant qui le met en défaut (en fournissant un contre-exemple Lean). Nous l'avons appliqué à trois bases de code de Kiro : le harnais d'agent Kiro, le client CLI et Kiro Crew. Nous avons demandé à Kiro CLI d'analyser les bases de code et de trouver des fonctions cibles relativement compactes, de sorte que la construction d'un modèle Lean soit faisable et que leur test ne soit pas trivial; ces cibles sont donc intéressantes. C'est une première étape vers un agent qui améliore le système dans lequel il s'exécute. Le noyau de Lean vérifie chaque preuve, le code réel vérifie chaque constat, et nous avons examiné chaque énoncé de théorème, car le noyau peut valider une preuve mal alignée sur le code source. Le résultat est un processus reproductible qui complète les tests là où le chemin de vérification est difficile à atteindre, comme les garanties du cache de requêtes et la concurrence. Une preuve acceptée par le noyau de Lean fournit des garanties pour chaque intrant modélisé, et non seulement pour l'ensemble fini d'intrants des tests unitaires. Une tentative de preuve qui échoue peut révéler un contre-exemple concret à exécuter sur le code réel.
Ce que nous avons prouvé. Sur 26 fonctions centrales du serveur d'agent Kiro (aussi appelé harnais Kiro), du Kiro CLI v3 et de Kiro Crew, Lean a prouvé 70 énoncés sur les modèles de ces fonctions, chacun pour chaque intrant modélisé qui satisfait les hypothèses énoncées du théorème. Chaque modèle a été vérifié par rapport au code réel sur des intrants échantillonnés (voir La méthode et Limites). Par exemple :
- La suppression des pièces jointes en double ne modifie jamais ce que le modèle a vu à un tour précédent; cette étape ne peut donc pas briser le préfixe du cache de requêtes à mesure que la conversation s'allonge.
- La combinaison de la décision d'autorisation d'un sous-agent avec celle de son parent ne donne jamais plus d'autorisation que celle du parent, et le resserrement d'une politique ne transforme jamais un refus en approbation.
- Une fois qu'une tâche de la file de Kiro Crew est confiée à un nouveau travailleur, aucune écriture clôturée de l'ancien travailleur ne peut la modifier, en supposant que chaque appel au magasin s'exécute comme une seule étape indivisible.
Ce que nous avons trouvé. Lorsqu'une preuve échouait, elle nous menait souvent à un cas limite que les tests n'avaient pas atteint, généralement à la frontière entre deux représentations ou deux programmes, ou dans un ordre rare d'événements concurrents. Nous n'avons compté une preuve échouée comme un constat qu'après l'avoir reproduite sur le code réel, non modifié.
Les suites de tests ordinaires, qu'elles soient écrites par des personnes ou générées par un LLM, vérifient les intrants auxquels quelqu'un a pensé ou qu'un générateur a produits, et ne peuvent pas détecter tous les cas limites. Dans un agent, la plupart des intrants proviennent du modèle et des fichiers qu'il lit; ils atteignent donc beaucoup plus de cas que quiconque n'en écrit dans un test. Le code qui les traite est souvent petit et semble manifestement correct : une troncature, une vérification de lecture seule, une correspondance avec une liste d'autorisation. C'est là qu'une preuve est la plus utile. Ces fonctions sont assez courtes pour être modélisées exactement, l'intention du code est assez précise pour être énoncée sous forme de théorèmes, et elles s'exécutent dans chaque session. Les suites de tests ordinaires non exhaustives échantillonnent le comportement; une preuve établit un résultat universel pour le modèle formel. La preuve porte toutefois sur le modèle; nous avons donc encore besoin de tests pour relier le modèle au code, comme décrit ci-dessous.
Dans le serveur d'agent, le CLI et Kiro Crew, le harnais repose sur quelques types de propriétés que des tests non exhaustifs ne peuvent qu'échantillonner :
- Contenu borné. Chaque élément de contenu qui entre dans la fenêtre de contexte du modèle a une limite de taille, et lorsque du contenu est coupé, l'agent peut récupérer le reste.
- Persistance. Le rechargement d'une session, même après un redémarrage, donne au modèle exactement les messages qu'il a vus en direct.
- Mise en cache des requêtes. Le début de chaque requête (la liste des outils, le premier message et l'historique) reste identique d'un tour à l'autre, de sorte que le fournisseur du modèle peut réutiliser son travail mis en cache.
- Autorisations. Une approbation couvre exactement ce que vous avez approuvé, et un sous-agent n'obtient jamais plus d'autorisations que son parent.
- Ordonnancement. Les sessions, les réponses en continu et les tâches en arrière-plan aboutissent au bon état, quel que soit l'ordre d'arrivée de leurs événements.
- Contrats entre dépôts. Lorsque deux bases de code dépendent l'une de l'autre, elles doivent établir des contrats entre dépôts. Par exemple, Crew traduit une même liste d'autorisation d'outils à la fois pour le serveur d'agent et pour le CLI, et le CLI doit conserver une mise à jour du serveur d'agent au début de la session. En général, les tests de chaque dépôt ne vérifient que le code de leur propre dépôt; un modèle Lean peut inclure les deux côtés et prouver qu'ils concordent.
Chacune est un énoncé portant sur tous les intrants, toutes les sessions ou tous les ordres d'événements. C'est la forme que prend un théorème, et la forme que des tests non exhaustifs ne peuvent qu'échantillonner.
Le travail a été réalisé par Kiro lui-même : le Kiro CLI, utilisant Claude Opus 5.5 servi par Amazon Bedrock et un ensemble de Skills Lean 4. L'agent a trouvé les cibles, a écrit les modèles Lean, les preuves, les tests différentiels et les scripts de reproduction, de petits programmes qui exécutent un contre-exemple sur le code réel, non modifié. Lean vérifie les preuves générées indépendamment de l'agent. Relier ces preuves au code de production dépend toutefois encore de l'exactitude des modèles, des énoncés de théorèmes et des bancs de tests différentiels, que nous avons examinés et testés séparément. Nous avons défini la portée, en choisissant les dépôts et les zones à cibler, et nous avons examiné les énoncés de théorèmes et les constats au fur et à mesure. Chaque théorème reformule une intention du code sous forme d'énoncé formel (l'intention du code est tirée de la documentation ou des invariants de conception, et chaque constat est confirmé sur le code réel). Nous avons utilisé uniquement la distribution Lean 4.28.0, sans dépendance Lake externe comme Mathlib. Le serveur d'agent est le harnais partagé derrière l'IDE Kiro, le Web et le CLI v3 (Un agent, toutes les surfaces), et les résultats du CLI s'appliquent au Kiro CLI v3. Nous avons analysé le serveur d'agent et le Kiro CLI dans leurs dépôts privés, et Kiro Crew au commit 909e0fc de son dépôt public. Les chiffres présentés dans cet article sont des résultats expérimentaux internes examinés par l'équipe Kiro.
Comme c'est un agent qui a écrit les preuves, nous avons aussi vérifié les façons dont Lean peut accepter une cible de preuve sémantiquement similaire à laquelle manque l'intention du code : une étape inachevée, un axiome supplémentaire ou des hypothèses qui ne peuvent jamais être toutes vraies. Nous avons listé les axiomes derrière chaque théorème, dix contre-exemples derrière cinq des constats et un cas témoin pour l'un de ces constats. Un théorème dont les hypothèses se contredisent est trivialement vrai (il est vide) et n'est donc pas utile. Pour chaque théorème que cet article cite ou décrit, nous avons fourni un intrant concret qui satisfait toutes ses hypothèses, vérifié dans Lean, de sorte que les hypothèses de chacun sont simultanément satisfiables.
Un modèle Lean est une deuxième implémentation d'une fonction, écrite en Lean. Il représente les intrants et les extrants observables de la source au moyen d'un encodage explicite, et il est écrit de façon que Lean puisse raisonner à son sujet. Les théorèmes portent sur le modèle, et non sur le code source : Lean ne peut pas lire Python, TypeScript ou Rust. Ainsi, selon cet encodage, le modèle doit calculer ce que calcule la source, et il doit être assez simple pour qu'on puisse prouver des choses à son sujet.
Voici un exemple tiré de la file de tâches de Kiro Crew, où des problèmes de concurrence peuvent survenir. La file conserve une ligne par tâche dans SQLite, et de nombreux répartiteurs, boucles d'exécution et rappels l'appellent en même temps. Deux répartiteurs peuvent tenter de prendre la même tâche au même moment, et un seul peut l'emporter. claim en décide avec un seul UPDATE protégé, exécuté sous le verrou du magasin et dans une transaction. Voici le cœur de ce code dans taskq/store.py :
Et voici son modèle Lean :
Le risque est une tâche qui s'exécute deux fois. Deux répartiteurs peuvent voir la même tâche en file au même moment et appeler tous deux claim pour la prendre. Si les deux appels réussissaient, deux agents feraient le même travail, et tout ce que la tâche modifie en dehors de Kiro serait modifié deux fois. Le théorème Lean ci-dessous exclut ce cas. Il indique que, juste après la réussite de l'appel claim d'un répartiteur, la tâche est admitted (prise et sur le point de démarrer), et qu'un appel claim de tout autre répartiteur, à tout moment, est refusé. Seule une écriture ultérieure qui remet la tâche dans la file, comme la planification d'une nouvelle tentative, la rend de nouveau disponible.
Le théorème est volontairement petit. Il découle de la garde dans claim et du fait que admitted n'est pas un état réclamable. Sa valeur ne tient pas à la difficulté de la preuve, mais au fait que la garde sur laquelle il repose est celle que les tests différentiels ont mise en correspondance avec le vrai SQL. Il porte sur la ligne juste après une réclamation réussie; stale_writer_fenced_out ci-dessous couvre ce qui se passe au fil des appels suivants. Il ne couvre la concurrence qu'au moyen d'une hypothèse : chaque transaction réussie est une transition d'état atomique. Selon cette hypothèse, deux appels claim ne peuvent pas réussir tous les deux sur la même ligne réclamable. Une connexion concurrente peut plutôt obtenir une erreur de verrouillage : BEGIN IMMEDIATE attend jusqu'au busy_timeout du magasin, puis échoue, et claim lève TaskStoreUnavailable. Les nouvelles tentatives, la disponibilité et ce chemin d'erreur sont hors de la portée de ce théorème. Une passerelle Crew prend un verrou de fichier sur son répertoire personnel, de sorte qu'une deuxième passerelle ne peut pas écrire dans la même base de données. Un autre processus, comme une session sqlite3 manuelle, le pourrait toutefois, et entre processus, seul le verrou d'écriture de SQLite assure cette garantie. Lean ne vérifie pas cette hypothèse.
Le modèle diffère de la source à quelques égards. C'est une fonction pure : l'état entre et le nouvel état sort. Le modèle considère des séquences d'appels, en traitant chaque opération du magasin comme une seule étape indivisible. C'est une hypothèse sur le magasin, et non quelque chose que Lean prouve : elle repose sur le verrou du magasin au sein d'un processus et sur les transactions de SQLite entre processus. Il représente les données de façon exacte là où un bogue pourrait se cacher, comme les heures, les encodages de chaînes et les limites en octets. Et il se compile en un programme ordinaire, ce qui nous permet de l'exécuter en parallèle avec le code réel.
Un modèle n'est utile que s'il fait ce que fait le code source. Chaque modèle commence par un en-tête indiquant le fichier source et les numéros de ligne, afin qu'un réviseur puisse comparer les deux côte à côte. Nous ne nous sommes pas fiés à cette seule révision : chaque modèle a été exécuté en parallèle avec le code réel sur des milliers d'intrants aléatoires, et nous avons corrigé le modèle jusqu'à ce qu'aucun extrant ne diffère (étape 3 ci-dessous). Un théorème est alors vrai pour le modèle sur chaque intrant modélisé qui satisfait ses hypothèses. Le test différentiel est une indication, et non une preuve, que le modèle et la source concordent : il montre qu'ils concordent sur chaque intrant que nous avons essayé, et il n'est aussi solide que les intrants que nous avons générés.
Il reste l'écart habituel entre un modèle et son code : la preuve couvre chaque intrant modélisé qui satisfait ses hypothèses, tandis que la correspondance entre le modèle et le code est vérifiée sur environ 100 000 intrants échantillonnés. Trois éléments maintiennent cet écart petit ici. Les fonctions sont courtes, les modèles conservent la structure du code source, et les générateurs visent les intrants où ces fonctions échouent, comme le texte multioctet, les longueurs à la limite et les événements réordonnés. Pour vérifier les tests eux-mêmes, nous avons modifié un comportement du côté du code réel pour deux des traqueurs, et les tests différentiels ont signalé des centaines de divergences.
Nous avons suivi les mêmes étapes dans chaque dépôt. La figure 1 présente l'ensemble du flux, y compris les deux endroits où une divergence nous renvoie corriger le modèle.
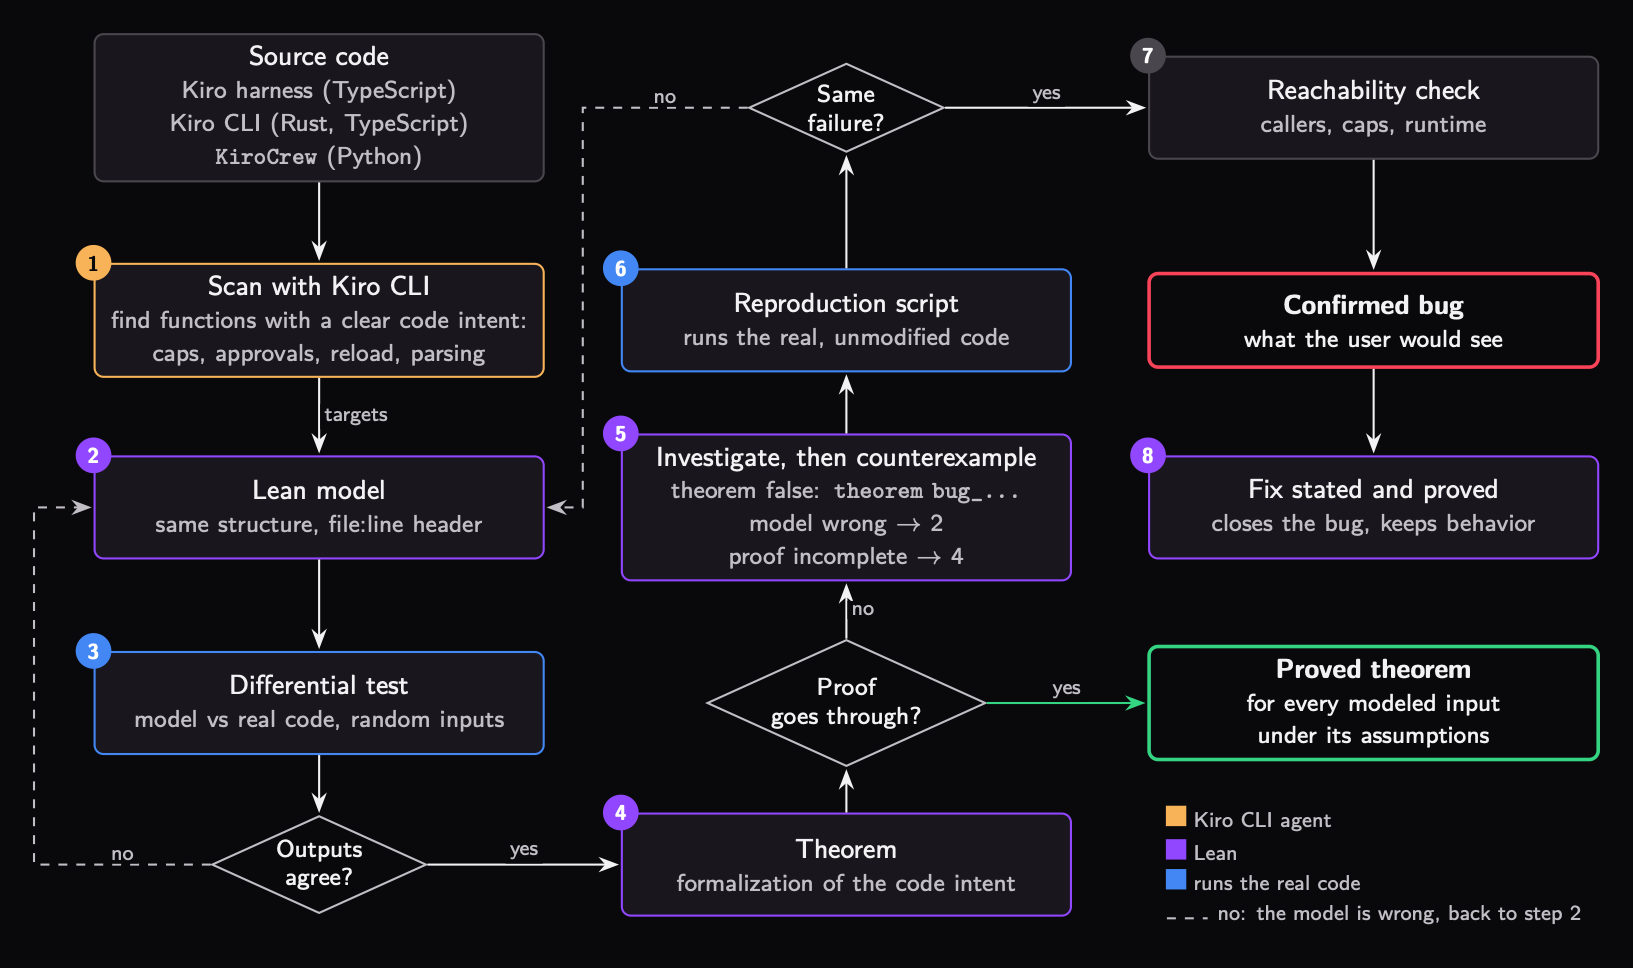
1. Trouver les cibles. Nous avons dirigé le Kiro CLI vers chaque dépôt (harnais Kiro, Kiro CLI et Kiro Crew) et lui avons demandé de trouver des fonctions dont le comportement peut s'énoncer sous forme de théorème : une limite de taille, une règle d'approbation, un rechargement qui doit correspondre à la session en direct, une machine à états qui ne doit jamais revenir en arrière. L'analyse a lu les commentaires de documentation, les invariants de conception et les sites d'appel, et a produit une liste classée de cibles avec le fichier source et la ligne de chacune. Le modèle décrit ce que fait le code, le théorème énonce le comportement qu'il doit respecter.
2. Modéliser. L'agent a écrit un modèle Lean de chaque fonction, comme décrit ci-dessus, en conservant la structure de l'original afin qu'un réviseur puisse les comparer ligne par ligne.
3. Vérifier le modèle par rapport au code réel. Une preuve sur le mauvais modèle ne prouve rien; avant de prouver quoi que ce soit, nous avons donc compilé chaque modèle Lean en exécutable et l'avons exécuté côte à côte avec l'implémentation réelle sur des milliers d'intrants aléatoires : TypeScript au moyen de Node ou de Bun, Rust au moyen d'un petit binaire lié à la vraie crate, Python en important le vrai module. Les intrants allaient de chaînes aléatoires et de séquences d'appels aléatoires jusqu'à des commandes shell exécutées sur de vrais bash et git, et les générateurs visaient les frontières : texte multioctet et CJK, longueurs juste en dessous et au-dessus de chaque limite, ordres d'événements mélangés et répétés, et rafales dépassant la limite de 64 mises à jour de la mise en attente au démarrage de session du CLI. Lorsque les extrants différaient, nous vérifiions quel côté était erroné et corrigions le modèle lorsque c'était lui. Les exécutions finales, 97 938 cas dans les trois bases de code, n'ont présenté aucune divergence.
4. Prouver. Nous avons énoncé chaque intention de code ciblée sous forme de théorème et l'avons prouvée. Une preuve bloquée peut avoir plusieurs causes : le théorème peut être faux, le modèle peut être erroné ou la preuve peut être incomplète. Nous avons examiné chaque preuve bloquée, et lorsque l'objectif sur lequel elle bloquait désignait un intrant qui met en défaut le comportement attendu, nous avons prouvé un théorème bug_… énonçant qu'un intrant précis viole le comportement attendu du code dans le modèle, de sorte que le contre-exemple lui-même est vérifié dans Lean. Pour deux propriétés, nous avons écrit une vérification bornée au lieu d'une preuve (ces propriétés reposaient sur des logiciels externes et il n'était donc pas possible de les modéliser fidèlement en Lean). Une vérification bornée couvre chaque intrant jusqu'à la borne, ou chaque cas d'une liste fixe, et rien au-delà. C'est pourquoi les deux vérifications bornées du tableau 1 sont comptées séparément et non comme prouvées.
5. Reproduire. Un contre-exemple n'était compté comme constat que lorsqu'un script exécutant le code réel, non modifié, montrait le même résultat. Nous avons ensuite vérifié si de vrais appelants peuvent atteindre cet intrant et déterminé ce qu'un utilisateur verrait le cas échéant.
Pour la plupart des constats, nous sommes allés un peu plus loin : nous avons écrit le correctif en Lean et prouvé qu'il comble la lacune sans modifier le comportement que le code doit conserver. Cela prouve que le modèle corrigé est correct; la modification du code qui met en œuvre le correctif nécessite son propre test différentiel avant que la preuve ne dise quoi que ce soit à son sujet.
| Base de code | Fonctions | Propriétés | Prouvées | Vérification bornée | Cas limites trouvés | Partiel ou observation | Théorèmes Lean | Cas de test |
|---|---|---|---|---|---|---|---|---|
| Harnais Kiro (TypeScript) | 15 | 51 | 36 | 0 | 9 | 6 | 111 | 23 281 |
| Kiro CLI (Rust, TypeScript) | 8 | 29 | 23 | 0 | 6 | 0 | 86 | 65 000 |
| Kiro Crew (Python) | 3 | 16 | 11 | 2 | 3 | 0 | 38 | 9 657 |
| Total | 26 | 96 | 70 | 2 | 18 | 6 | 235 | 97 938 |
Tableau 1. Résultats de vérification et vérifications complémentaires pour le harnais Kiro, le Kiro CLI et Kiro Crew. Dans chaque ligne, Propriétés correspond à la somme des quatre colonnes de résultats. Prouvées compte les propriétés prouvées pour chaque intrant modélisé qui satisfait les hypothèses énoncées du théorème. Vérification bornée compte les propriétés vérifiées sur chaque cas jusqu'à une borne de taille, ou sur une liste fixe de cas; elles ne sont pas comptées comme prouvées. Partiel ou observation compte les propriétés prouvées seulement en partie et les observations sur du code qui n'est pas atteignable. Les théorèmes Lean comprennent les lemmes dont les preuves ont besoin; les cas de test sont les intrants générés des tests différentiels : un intrant pour une fonction pure, ou une séquence d'appels aléatoire pour une fonction avec état.
Lean a prouvé 70 des 96 propriétés, chacune pour chaque intrant modélisé qui satisfait les hypothèses énoncées du théorème (les propriétés restantes ont abouti à un bogue découvert ou à un constat partiel / une observation). Voici celles que nous jugeons les plus utiles, car chacune dépend de nombreux intrants ou de l'ordre des événements, là où les tests sont les plus minces.
La suppression des fichiers en double préserve le préfixe de la requête. Lorsque le même fichier est joint plus d'une fois, le harnais Kiro ne conserve qu'une seule copie de son contenu avant d'envoyer la requête. Si cette étape modifiait des messages antérieurs à mesure que la conversation s'allonge, chaque tour changerait le préfixe réutilisable, ce qui peut empêcher la réutilisation du cache. Nous avons prouvé que, pour tout historique xs et tous nouveaux messages ys, le résultat pour xs suivi de ys commence par le résultat pour xs. Cette étape ne réécrit donc jamais ce que le modèle a vu au tour précédent, quel que soit le nombre de fichiers et dans n'importe quel ordre. Le théorème ne couvre que la déduplication; le préfixe de la requête dépend aussi des autres étapes qui construisent la requête.
L'historique survit aux modifications et aux rechargements. Le harnais Kiro conserve les messages supprimés et annulés dans le fichier de session et les résout lorsqu'il construit l'historique. Nous avons prouvé que résoudre deux fois donne le même résultat que résoudre une fois, que le résultat ne fait que retirer des messages sans jamais les réordonner, et qu'une session dérivée commence toujours par l'historique effectif de son parent. Après un rechargement, chaque carte d'outil se termine dans l'état que l'utilisateur a vu en direct, pour les huit états d'appel d'outil (en attente d'approbation, en cours, réussi, accepté, erreur, erreur gérée, annulé et rejeté).
La sortie coupée ne dépasse jamais sa limite. L'agent du CLI coupe la sortie des commandes shell et d'autres résultats d'outils à une limite en octets avant qu'ils n'entrent dans la fenêtre de contexte. Nous avons prouvé que le texte coupé n'est jamais plus long que la limite en octets UTF-8, pour toute chaîne UTF-8 valide, y compris lorsqu'un avis de troncature est ajouté (un avis plus long que la limite est lui-même coupé pour tenir), et que, sans avis, il conserve le plus long préfixe qui tient sans couper un caractère. Le modèle a concordé avec les vraies fonctions Rust sur environ 4 000 cas de texte multioctet.
L'état de la session tient bon lorsque les événements se terminent dans le désordre. Le harnais Kiro indique aux clients si une session est occupée, en attente de l'utilisateur ou inactive, y compris pour les flux de travail en arrière-plan qu'il a lancés. Les événements des flux de travail sont traités par des chaînes asynchrones distinctes qui peuvent se terminer dans n'importe quel ordre, et le traqueur utilise un numéro de séquence pour les remettre en ordre. Nous avons prouvé que, pour les événements qui démarrent, mettent en pause et terminent une exécution, chaque ordre de livraison donne le même état que l'ordre d'origine. La preuve couvre chaque permutation, et non un échantillon. Nous avons vérifié le modèle par rapport au vrai traqueur sur 6 000 séquences d'événements aléatoires, la plupart livrées dans le désordre.
Un sous-agent n'est jamais moins restreint que son parent. Lorsque le harnais Kiro lance un sous-agent, il combine la décision d'autorisation propre au sous-agent avec celle de son parent. Nous avons prouvé que le résultat est toujours l'une des deux décisions et toujours la plus restrictive des deux, et qu'un refus ou une demande explicite du sous-agent n'est jamais affaibli. Ainsi, par cette étape, un sous-agent ne peut pas approuver un appel d'outil que son parent refuserait ou au sujet duquel il demanderait confirmation, quelles que soient les deux politiques. Nous avons aussi prouvé que le resserrement d'une politique ne transforme jamais un refus en approbation, le resserrement signifiant que la décision devient au moins aussi restrictive dans l'ordre autoriser, demander, demander explicitement, refuser, et qu'un chemin absolu normalisé ne peut pas remonter au-dessus de sa racine avec ...
Une liste d'autorisation, deux backends. Crew permet aux utilisateurs d'écrire des listes d'autorisation d'outils dans le format allowedTools du CLI et les traduit en motifs de politique du harnais Kiro. Nous avons modélisé les trois mécanismes de correspondance (la traduction de Crew, le moteur de correspondance de politiques du harnais Kiro et le moteur de correspondance glob du CLI), vérifié chaque modèle par rapport au code réel et prouvé que la traduction n'accorde jamais plus sur le harnais que le CLI ne le ferait, pour toute entrée sans barre oblique inverse (kas_le_cli). Une entrée avec une barre oblique inverse peut accorder plus sur le harnais Kiro; c'est l'un des trois constats de Crew, et nous avons prouvé un correctif qui refuse de telles entrées.
Le repli de modèle s'arrête. Lorsqu'un modèle refuse une requête, la logique de repli du CLI passe à un autre modèle. Nous avons prouvé qu'elle ne change jamais de modèle plus de trois fois au cours d'un tour et ne passe jamais à un modèle déjà essayé pendant ce tour, pour toute séquence de refus et d'appels.
Deux répartiteurs ne prennent jamais la même tâche. Lorsque plusieurs répartiteurs se disputent une même tâche en file, un seul appel claim peut réussir. Juste après, la tâche est admitted, et un appel claim de tout autre répartiteur est refusé (claim_exclusive, le théorème de l'exemple ci-dessus). Le modèle traite chaque appel au magasin comme une seule étape indivisible, comme le garantit le verrou du magasin; selon cette hypothèse, deux appels claim ne réussissent jamais sur la même ligne réclamable, dans n'importe quel ordre; un appel concurrent peut plutôt échouer avec une erreur de verrouillage, que le théorème ne couvre pas.
La file de tâches écarte les travailleurs périmés. La file de tâches de Kiro Crew fait passer chaque tâche par 15 états, de queued à running et aux états d'attente, jusqu'à done, failed ou cancelled. Chaque appel claim réussi augmente la génération de la ligne, et les écritures qu'un travailleur effectue ensuite indiquent la génération qu'il détient. Nous avons prouvé, pour toute séquence d'appels, que la génération ne diminue jamais; ainsi, une fois la tâche prise par un nouveau travailleur, aucune écriture clôturée de l'ancien travailleur ne peut modifier la ligne :
Le modèle a concordé avec le vrai magasin, exécuté sur SQLite, sur 4 500 séquences aléatoires totalisant environ 20 000 appels. Ces séquences exécutaient un appel à la fois; elles testent donc la logique de chaque appel, et non la concurrence du magasin. L'affirmation sur les travailleurs concurrents repose sur l'hypothèse d'atomicité ci-dessus.
Dix-huit intentions de code ont été réfutées dans le modèle, et pour chacune, nous avons reproduit le contre-exemple sur le code analysé (pour la situation de concurrence au démarrage de session, au niveau du module). De tels cas limites sont normaux dans du code de cette taille. Lorsque nous avons parcouru les tickets GitHub du CLI et de Kiro Crew ainsi que les pull requests du serveur d'agent le 1er octobre 2026, aucun ticket ouvert ne correspondait à l'un d'eux, bien qu'une pull request ouverte du serveur d'agent corrigerait un constat et qu'une autre en décrivait une partie. Chacun exige un intrant inhabituel ou un moment particulier. Plusieurs échouent de façon sûre : l'utilisateur se voit redemander, ou le modèle voit un peu plus ou un peu moins de texte que prévu. Pour la plupart d'entre eux, nous avons aussi prouvé un correctif en Lean.
Examinons le bogue de concurrence concret découvert dans la base de code de Kiro Crew.
Une tâche annulée qui s'exécute quand même, voir la PR 25130. Kiro Crew peut exécuter une tâche une seule fois à une heure fixée, et l'utilisateur peut l'annuler pendant son exécution. L'intention du code est qu'une tâche « unique » annulée ne s'exécute plus jamais. Voici le scénario qui met ce comportement en défaut. Si l'utilisateur clique sur Cancel run alors que la tâche attend encore de commencer son travail, l'annulation arrête l'exécution mais laisse la tâche activée; le planificateur l'exécute donc de nouveau quelques secondes plus tard, et les notes de version sont publiées malgré tout. Les tests ne détectent pas ce cas, car l'annulation doit survenir dans le bref instant qui précède le début du travail de la tâche. Lean l'a trouvé sous forme de contre-exemple : une séquence de dix événements dans le modèle du cycle de vie de la tâche, qui se termine avec le travail de la tâche exécuté après l'annulation. Nous avons reproduit la séquence sur le vrai planificateur. Le correctif consiste en une seule condition dans l'annulation, et avec elle, Lean prouve qu'aucune séquence d'événements n'exécute de nouveau une tâche annulée.
Les principaux groupes d'autres bogues découverts sont :
- Une situation de concurrence. Deux sessions qui démarrent en même temps peuvent interférer : si une autre session s'enregistre auprès du CLI pendant que
session/newest en cours, une mise à jour envoyée pendant le démarrage de la session, comme un appel d'outil provenant d'un Hook de démarrage de session, peut être perdue. De telles situations de concurrence sont difficiles à détecter avec des tests, car un test exécute un seul ordre d'événements et le bogue n'apparaît que dans un autre. En Lean, nous avons énoncé le théorème sur chaque séquence d'événements de démarrage de session dans le modèle, pour un nombre quelconque de sessions. La preuve n'a pas abouti, et nous avons écrit l'entrelacement qui perd la mise à jour sous forme de théorèmebug_…vérifié dans Lean. Nous avons ensuite rejoué cet entrelacement sur le vrai code du CLI qui conserve et rejoue les mises à jour de session, importé sans modification et connecté à une copie de la table des gestionnaires du client. Il s'agit d'une reproduction au niveau du module, et non d'une reproduction de bout en bout dans le CLI en cours d'exécution. - Des limites mesurées dans la mauvaise unité. Sept des neuf constats du harnais Kiro se trouvent dans les fonctions qui coupent du texte pour respecter une limite.
web_fetcha un budget en octets, mais coupe la page selon la longueur de chaîne JavaScript, qui compte les unités de code UTF-16, en conservant deux fois moins d'unités de code que le budget ne compte d'octets. Cela suppose que chaque unité de code occupe au plus deux octets en UTF-8. Un caractère chinois ou japonais est une seule unité de code, mais trois octets en UTF-8; une telle page peut donc revenir avec jusqu'à 1,5 fois la limite. Le mode par défaut n'indique pas non plus qu'une page a été coupée. Une coupe comptée en unités de code UTF-16 peut scinder un émoji à la toute fin du texte.grep_searchraccourcit les lignes de correspondance, mais pas les lignes de contexte; une seule ligne de contexte très longue, par exemple tirée d'un fichier minifié, peut donc pousser les correspondances hors du résultat limité. Rien n'échoue dans ces cas; le modèle voit un peu plus ou un peu moins de texte que prévu. - Sortie de commande très volumineuse. Une commande shell, un Hook ou une étape de flux de travail qui affiche plus de 2^29 − 24 unités de code UTF-16 de sortie (environ 512 Mio de texte ASCII) dépasse la plus longue chaîne que V8 peut construire dans la version que nous avons testée (Node 26.3.0 avec V8 14.6, sur macOS arm64), et le harnais s'exécute sur Node, qui utilise V8. Le harnais Kiro rassemble la sortie en une seule chaîne avant que ses limites de taille ne s'appliquent; l'erreur survient donc avant la limite. Rien ne l'intercepte, et le gestionnaire d'erreurs non interceptées du harnais Kiro quitte le processus, ce qui met fin à ses sessions ouvertes. Le collecteur du harnais Kiro pour les terminaux en arrière-plan ne conserve déjà que la sortie la plus récente, et nous avons prouvé qu'il ne peut jamais atteindre cette limite (
tail_join_safe); le correctif consiste donc à l'utiliser pour chaque commande. - Règles de Spec après un rechargement à froid. En mode Spec, le chemin en direct et le chemin de rechargement attachent des règles implicites à des messages différents; un tour après un rechargement à froid diffère donc légèrement de la requête que la session en direct aurait envoyée et modifie une fois le préfixe réutilisable, ce qui peut empêcher la réutilisation du cache pour ce tour.
- Caractères glob dans un chemin approuvé. Le CLI transforme un chemin « toujours autoriser » en motif glob sans l'échapper. Pour une route Next.js comme
app/[slug]/page.tsx, cela signifie qu'on vous redemande au sujet du fichier que vous avez approuvé, et qu'un chemin différent commeapp/s/page.tsxest aussi approuvé. Nous avons prouvé le correctif dans le modèle : échapper d'abord le chemin, et l'autorisation correspond alors exactement au chemin approuvé et aux fichiers qu'il contient, tandis que les chemins ordinaires restent inchangés.
Deux autres intentions de code n'ont pas tenu non plus, mais nous n'avons trouvé aucun chemin d'appel atteignable en production vers l'intrant qui les met en défaut. C'est pourquoi nous les comptons comme des observations plutôt que comme des constats. Il s'agit de deux observations sur le harnais Kiro du tableau 1, et elles ne font pas partie des dix-huit. Aucun des bogues dans l'une ou l'autre des trois bases de code ne constituait un constat de sécurité.
Les preuves conviennent bien au harnais. La gestion du contexte, les autorisations et les machines à états qui les entourent se prêtent à des théorèmes courts et exacts : le même préfixe au tour suivant, la même requête après un rechargement, une approbation qui couvre exactement un fichier, un résultat valable dans n'importe quel ordre d'événements. Les fonctions qui les sous-tendent sont petites et se traduisent directement en Lean. La plupart des propriétés prouvées et quinze des dix-huit constats relèvent de ces domaines, et la plupart des constats se situent à la frontière entre deux représentations, comme UTF-16 et UTF-8, ou un chemin de fichier et un glob. Écrire les deux côtés dans un même langage a montré où ils divergent.
Le test différentiel compte autant que la preuve. Les tests différentiels nous ont aidés à trouver et à corriger des erreurs dans les modèles Lean. Lorsque Lean ne parvenait pas à terminer une preuve, l'objectif restant révélait souvent l'intrant à l'origine de l'échec. Nous avons ensuite prouvé que le correctif respectait le comportement attendu, et non seulement cet intrant précis.
Une preuve établit une propriété du modèle Lean, selon les définitions et les hypothèses du modèle. Ce qu'elle nous apprend sur le système réel dépend d'éléments que la preuve ne vérifie pas par elle-même :
- Le modèle doit correspondre à ce que fait le code. L'agent a écrit chaque modèle à partir de la source, et un modèle peut omettre quelque chose que fait le code. Les tests différentiels vérifient le modèle par rapport au code réel, mais seulement sur des intrants échantillonnés; une différence sur un intrant que nous n'avons jamais généré passerait donc inaperçue. Certains modèles reposent aussi sur une hypothèse énoncée, comme la file de tâches qui traite chaque appel au magasin comme une seule étape indivisible.
- Le théorème doit énoncer ce que le code doit faire. L'agent a écrit chaque théorème à partir des commentaires de documentation, des invariants de conception et des sites d'appel, et nous les avons examinés. Si un théorème omet une partie du comportement attendu, un bogue peut s'échapper même lorsque la preuve réussit.
- Les types du modèle doivent être fidèles. Lorsqu'un modèle utilise les entiers naturels non bornés de Lean ou abstrait une structure de données, il ne capture pas le dépassement de capacité, le comportement en virgule flottante ni le coût d'une opération. Nous avons modélisé des représentations exactes là où l'énoncé précis du comportement du code (théorème ou lemme) en dépend, comme les longueurs UTF-8 et UTF-16.
- La base de confiance est plus large que le noyau. Les preuves dépendent du noyau de Lean. Les tests différentiels dépendent aussi du compilateur Lean, du banc d'essai qui fournit les mêmes intrants aux deux côtés et des environnements d'exécution du code réel. Les 17 théorèmes qui utilisent
native_decidefont aussi confiance au compilateur Lean et à la chaîne d'outils C avec laquelle il compile. Aucun d'eux ne sous-tend une propriété prouvée : ce sont des vérifications bornées, des contre-exemples et un cas témoin, et chaque contre-exemple a aussi été reproduit sur le code réel. - Les résultats sont liés à un commit. Chaque modèle décrit le code au commit que nous avons analysé. Une modification ultérieure du code n'est pas couverte tant que le modèle n'est pas mis à jour et que les tests différentiels ne réussissent pas de nouveau.
Ces problèmes sont bien connus en autoformalisation, où la principale difficulté consiste à s'assurer qu'un énoncé Lean capture fidèlement l'original, qu'il s'agisse d'une affirmation mathématique en langage naturel ou de code dans un autre langage de programmation. Pour les constats, le code réel tranche la question : nous avons rejoué chaque contre-exemple sur celui-ci, et un échec à ce niveau confirme le bogue indépendamment du modèle. Nous avons jugé que les tests différentiels et notre examen des énoncés de théorèmes constituaient des éléments suffisants pour faire confiance aux preuves. Nous avons appliqué la méthode à 26 fonctions où elle est rentable : de petits énoncés compacts, principalement à la frontière entre deux représentations. Nous avons évalué si chaque constat est atteignable à partir du code qui l'appelle.
La gestion du contexte de Kiro repose sur des propriétés du harnais telles que le contenu de la fenêtre de contexte est borné, une session rechargée reste inchangée et la mise en cache des requêtes reste intacte tout au long de la trajectoire. Jusqu'à présent, ces hypothèses vivaient dans des documents de conception et des tests unitaires. Pour les fonctions présentées dans cet article, ce sont désormais des théorèmes sur des modèles Lean, chacun relié au code réel par des tests différentiels sur des intrants échantillonnés. Cela couvre ces fonctions aux commits que nous avons analysés, et non l'ensemble du harnais.
Cela donne une base à notre feuille de route. Nous prévoyons d'énoncer chacune sous forme de théorème pendant la conception de la fonctionnalité, et de relancer les tests différentiels chaque fois que le code change, afin d'aider à détecter les régressions avant la révision. Les étapes sont automatisées, mais chaque énoncé de théorème et chaque constat nécessite encore l'examen d'une personne; l'extension des vérifications à d'autres dépôts Kiro dépend donc de l'effort de révision autant que de la puissance de calcul. L'objectif est qu'une plus grande partie du comportement central du harnais soit prouvée plutôt que supposée.
Pour commencer avec Lean, consultez la documentation de Lean. Pour en savoir plus sur le fonctionnement du harnais d'agent Kiro, lisez Un agent, toutes les surfaces, et téléchargez Kiro pour l'essayer sur votre propre base de code.