Comment Kiro se corrige lui-même, et comment nous gardons ces correctifs honnêtes
Myeongsoo Kim
Applied Science
Patrick Chapman
Applied Science
Chang Liu
Applied Science
Mingwei Zheng
Applied Science
Berk Cirisci
Applied Science
Sam Mayers
Applied Science
Joe Hsu
Applied Science
Liam Bouayad-Agha
Engineering
Shweta Garg
Applied Science
Une seule phrase dans les descriptions des outils de lecture de fichiers et de recherche de Kiro affirmait à tort quelque chose sur le comportement du harnais, et elle a atteint le modèle 61 742 fois au cours de quelques centaines de sessions. Elle ne servait à rien, et il est peu probable que quiconque ait ouvert un ticket à son sujet. Les problèmes de ce genre sont difficiles à trouver, et les correctifs sont tout aussi difficiles à juger. Par exemple, nous avons failli livrer un correctif qui réussissait plus de tâches et consommait moins de jetons, jusqu'à ce que nous ventilions les résultats par hôte et constations que presque tout le gain venait d'une seule exécution où l'agent avait réussi par hasard à sortir d'une boucle dans laquelle il reste habituellement coincé. Sans cet hôte, le correctif était plus lent, plus coûteux et moins précis. Une boucle qui évalue ses propres correctifs l'aurait livré.
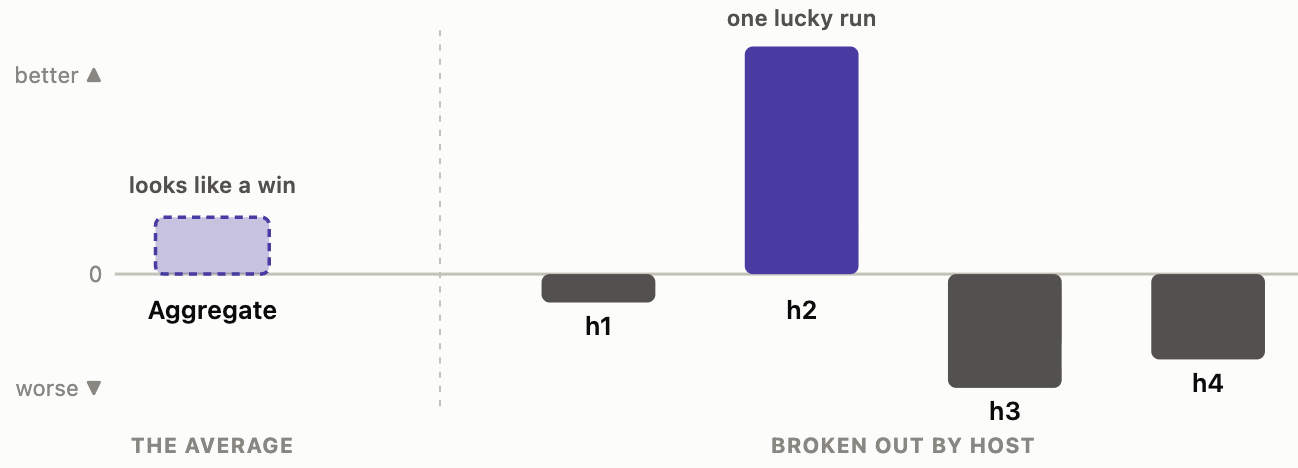
Nous avons créé un système de traçage interne pour améliorer Kiro, notre agent de programmation par IA, à partir de ses propres exécutions. Ce système, nommé kiro-trace à l'interne, lit ces exécutions pour trouver où Kiro échoue ou gaspille des efforts, propose un changement et ne conserve ce changement que s'il résiste à des vérifications conçues pour le rejeter. Ces vérifications servent aussi à intercepter des résultats comme le précédent, qui ressemblait à une victoire mais n'était en réalité qu'un coup de chance. Les modèles peuvent proposer des changements, mais nous utilisons du code déterministe pour les accepter ou les rejeter.
Au cours de sa première semaine, kiro-trace a ouvert huit pull requests vers Kiro. Sept ont été fusionnées, une a été fermée pour des raisons sans rapport, et aucune n'a été renvoyée lors de la revue de code. Les sept ont modifié les requêtes ou les outils de Kiro, ses descriptions d'outils, ses vérifications d'arguments et son comportement de réponse. Chacune ciblait une tendance précise que nous avions mesurée, et chacune l'a améliorée. Quelques-unes figurent plus loin dans ce billet avec leurs résultats. Les autres ne sont jamais apparues sous forme d'erreur visible pour un utilisateur, et aucun ticket ne les signalait. Une personne aurait pu les trouver, mais seulement en lisant bien plus d'exécutions que quiconque n'en a le temps. C'est ainsi que Kiro continue de s'améliorer par lui-même.
Les chiffres suivants proviennent de l'utilisation interne de Kiro chez Amazon, et chaque valeur est un écart mesuré lors d'une expérience interne, pas une estimation en production. Un billet complémentaire, Évaluation continue des requêtes, explique comment nous évaluons les modifications de requêtes rédigées par des humains à l'aide de juges LLM et de tests A/B en direct. Celui-ci prend le relais à partir de là, avec l'exploration automatisée des trajectoires, la génération de changements et l'auto-amélioration du harnais.
Les modules principaux de Kiro ont reçu 141 commits de correction de bogues le mois dernier, près de cinq par jour, et il ne s'agit que des défaillances qu'un humain a repérées et a eu le temps de corriger. Les pires problèmes ne se présentent généralement pas sous forme de rapports de bogue clairs. Ils se cachent dans la façon dont l'agent se remet d'une erreur, dont il enchaîne les outils et dont il gère un long contexte, et on ne les remarque qu'après avoir parcouru des milliers d'exécutions réelles. La phrase de description d'outil évoquée au début de ce billet est un exemple de ce genre de problème.
Le travail consiste donc à trouver les endroits où Kiro échoue ou gaspille des efforts, et à modifier Kiro pour qu'il s'améliore sans régression ailleurs. C'est plus large que la correction de bogues. Cela couvre les descriptions d'outils trompeuses, les appels d'outils rejetés pour un détail technique, les appels et les jetons gaspillés, une mauvaise reprise après les erreurs et les instructions qui n'aident plus. Personne ne peut lire des milliers d'exécutions à la main pour trouver ces problèmes, alors le travail doit être automatique. Le raccourci évident, laisser l'agent s'améliorer lui-même de bout en bout, est justement là où la plupart des boucles d'auto-amélioration dérapent. Une boucle qui évalue son propre correctif livrera des bricolages étroits et passera à autre chose. Pour bien faire les choses, kiro-trace doit résoudre quatre problèmes à la fois : 1) trouver une défaillance qui vaut la peine d'être corrigée, 2) écrire un changement qui en cible la cause, 3) garder la solution générale plutôt qu'ajustée au test de référence, et 4) prouver que le changement a amélioré les résultats. La boucle qui s'évalue elle-même saute l'étape 4, et sans elle, impossible de savoir si les étapes 1 à 3 en valaient la peine.
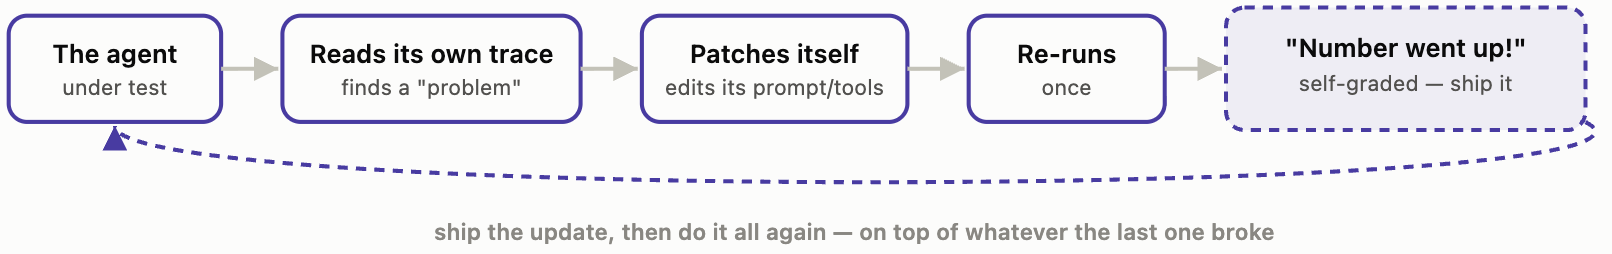
La boucle illustrée vérifie chaque changement uniquement par rapport au problème qu'il visait, de sorte qu'un nouveau changement peut casser quelque chose qu'un changement antérieur avait corrigé sans que cette boucle s'en aperçoive. Cela se produit quand rien à l'extérieur de la boucle ne vérifie les régressions. Dans kiro-trace, les candidats sont aussi exécutés sur des tâches que Kiro réussit déjà, le candidat final est comparé sur le test de référence complet à un témoin inchangé, et la pull request passe quand même par la revue de code habituelle avant d'être fusionnée.
Le diagramme ci-dessous montre un passage dans la boucle. Les éléments probants issus des tests de référence et des plaintes du trafic en direct approuvées par des humains entrent par la gauche. La boucle lit la défaillance, la diagnostique, choisit un seul levier à modifier et exécute le même Kiro avec le changement désactivé puis activé. Une barrière en trois étapes (présélection, régression, confirmation) tranche ensuite. Les changements qui passent deviennent une pull request qu'un humain fusionne, et ceux qui sont rejetés retournent au diagnostic.
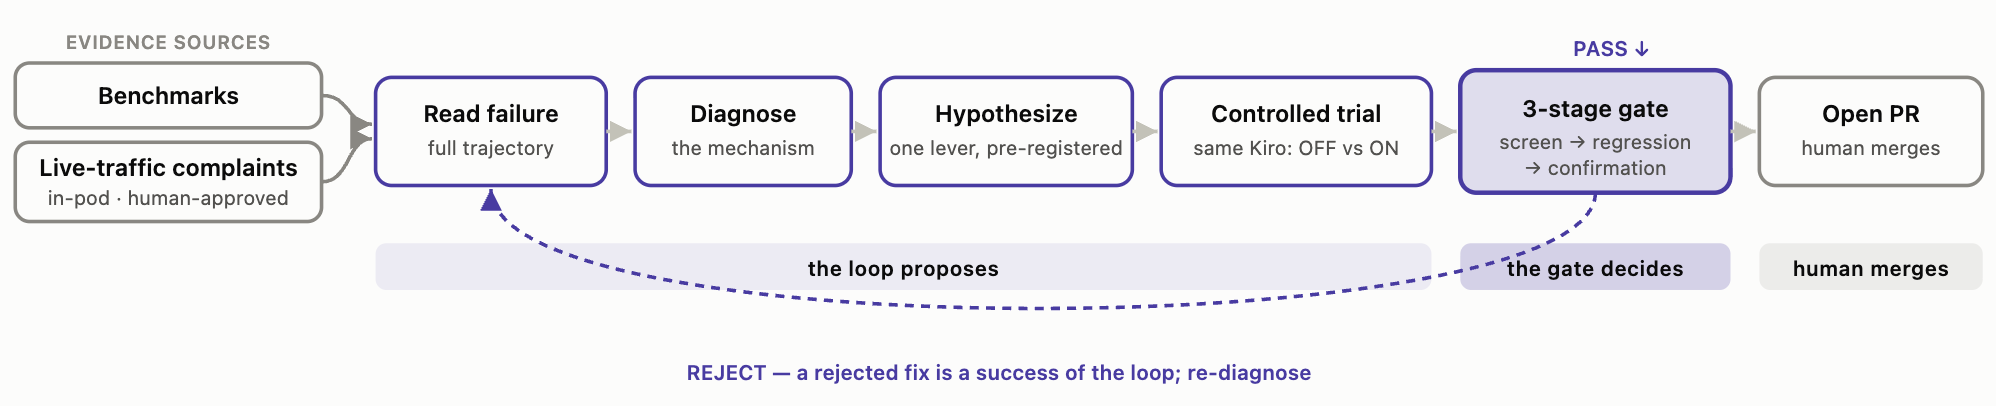
Nous gardons toujours trois rôles séparés, parce que tout ce qui à la fois écrit un changement et décide s'il a fonctionné aura tendance à l'accepter. Nous l'avons appris en partie de notre propre erreur. En jugeant des comparaisons à la main, nous avons un jour interprété la même exécution de trois façons différentes, et c'est pourquoi la décision se trouve maintenant dans le code. Kiro est l'agent qu'on améliore. La boucle propose et applique un changement. La barrière, qui est du code ordinaire, décide si le changement survit. En dehors de ces trois rôles, un humain prend la décision finale de fusion. Voici ce que nous avons appris en construisant chaque partie.
Exécuter un test de référence complet à chaque tour est lent et coûteux, et les tâches ne sont pas interchangeables. Certaines expirent, certaines sont en réalité des tests de contexte long, et certaines échouent à cause du harnais d'évaluation plutôt que de l'agent. La boucle utilise donc ce qu'elle sait déjà de chaque tâche, son mode de défaillance, son coût et le fait qu'elle constitue ou non un vrai signal, pour assembler un petit ensemble qui couvre les modes de défaillance sans le poids mort. Elle itère sur ce petit ensemble, ce qui est rapide et peu coûteux. Le test de référence complet ne s'exécute qu'une seule fois, à la fin, après qu'un candidat a réussi sur le petit ensemble. Nous comparons une exécution complète avec le changement à une exécution témoin inchangée, et un changement qui l'emporte sur le petit ensemble mais pas sur l'exécution complète n'est pas livré.
Un juge LLM générique peut lire n'importe quelle exécution et suggérer un correctif, mais il ne connaît ni votre boucle d'agent ni votre couche d'inférence. Le réviseur de kiro-trace lit les vrais commentaires de revue de code et les discussions des développeurs de Kiro, de sorte qu'il signale ce que cette équipe signalerait. Les idées qu'il examine viennent d'éléments probants. Quand Kiro échoue à une tâche, la boucle exécute un panel d'agents de référence sur la même tâche, avec les mêmes intrants et le même budget. Les agents de référence sont d'autres modèles et agents performants dont nous comparons les exécutions à celles de Kiro. Quand l'un d'eux réussit là où Kiro a échoué, cette différence est un comportement concret que la boucle peut transformer en correctif. Une étape de recherche distincte puise dans des travaux externes, des articles scientifiques au code public en passant par la façon dont des agents comparables résolvent le même problème, pour en tirer la technique générale. Elle ne copie pas leur code. Chaque candidat consigne la défaillance qu'il a diagnostiquée et les éléments probants qu'il a cités, de sorte que chaque correctif peut être relié à son raisonnement. Par défaut, elle essaie de retirer quelque chose avant d'ajouter une règle, parce que les modèles modernes en savent déjà beaucoup.
Exécuter un correctif quelques fois et lire la moyenne ne donne pas de résultats constants, parce qu'une seule valeur aberrante peut la faire basculer, comme dans l'exemple précédent. Un changement passe donc par une série croissante de vérifications, en commençant par les moins coûteuses, et la plupart des candidats échouent avant que les vérifications coûteuses ne s'exécutent. Contrairement à un simple test A/B, nous mesurons l'écart plutôt que le score, en réexécutant le témoin chaque fois, de sorte qu'un gain rapporté correspond à la contribution de ce changement précis, et non à quelque chose qu'un nouveau modèle aurait produit de toute façon. Et un changement doit démontrer qu'il n'a pas régressé au-delà d'une marge fixée, parce qu'avec de petits échantillons, un test faible ne trouve rien de significatif par défaut, mais peut introduire un réel préjudice. Enfin, une vérification de contamination écarte toute réussite où l'agent a utilisé le réseau pour chercher la réponse de la tâche, par exemple en récupérant son code source ou ses tests, au lieu de la trouver par lui-même.
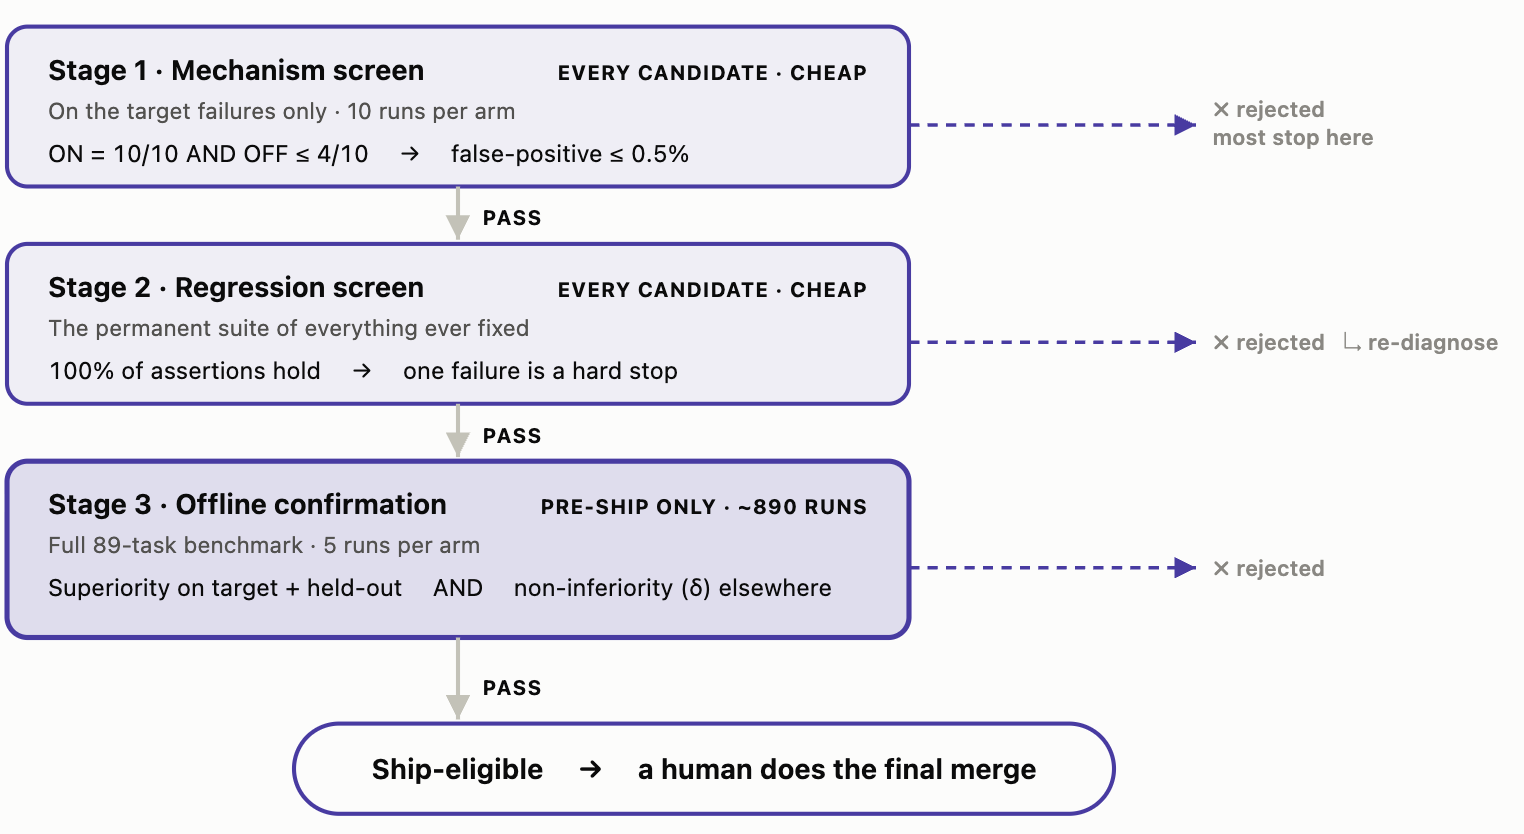
Comme les candidats faibles sont éliminés tôt, les changements qui parviennent à un réviseur humain sont généralement significatifs. En voici quelques-uns. Chaque chiffre est un écart mesuré lors d'une expérience interne.
- Une fausse affirmation sur le comportement du harnais à chaque lecture de fichier et recherche. Le modèle l'a vue 61 742 fois sur 445 échantillons et rien n'en a tenu compte, alors nous l'avons retirée.
- Des consignes qui demandaient au modèle d'appeler un outil qui n'existe pas. Nous les avons supprimées.
- Les relectures de fichiers redondantes réduites d'environ 83 pour cent, en ne relisant plus un fichier qui n'a pas changé.
- Deux contrats d'outils trop stricts ou mal documentés corrigés, ce qui a éliminé 205 rejets de schéma de l'outil de lecture et 167 rejets d'orchestration de sous-agents sur 80 sessions échantillonnées.
- Les intrants d'outils à typage strict ont cessé d'échouer pour un détail technique. Quand le modèle renvoyait un booléen sous la forme de la chaîne « true » au lieu d'un booléen brut, l'appel était rejeté et le travail s'enlisait. Ces valeurs sont maintenant corrigées lors d'une nouvelle tentative, de sorte qu'un appel dont l'intention est la bonne aboutit.
- Un bogue silencieux de recherche de fichiers qui faisait échouer environ une recherche sur huit. Une spécification erronée renvoyait des résultats vides sans erreur, si bien que l'agent cherchait et ne trouvait rien. Corrigé.
- La délégation trop zélée réduite à la source, en retirant les instructions générales de délégation qui lançaient des sous-agents pour de simples modifications directes, tout en conservant la délégation là où elle aide.
L'ajout d'un agent de référence plus strict au panel a révélé quelque chose que nous ne cherchions pas. Un bogue de chemin relatif qui faisait échouer de 13 à 17 pour cent des lectures de cet agent n'apparaissait qu'à 1,6 pour cent sur le modèle que nous livrons. Le modèle plus tolérant absorbait un défaut de spécification sans erreur. Corriger la spécification aide chaque modèle qui partage le même contrat, et ce correctif est en cours de revue.
Le changement le plus important n'a pas encore été livré et fait l'objet d'une revue par l'équipe. En retirant de façon agressive, la boucle a construit un profil d'outils et de requêtes plus léger qui a obtenu 82,4 pour cent contre 77,5 pour cent en pass@1 (la part des tâches résolues dès la première tentative) sur Terminal-Bench 2.1, pour environ le tiers du coût en jetons. Il n'a pas été livré parce qu'il changerait les outils et la requête par défaut pour chaque utilisateur de Kiro, ce qui relève davantage d'une décision de produit que d'un test de référence. L'équipe détermine si le profil plus léger doit devenir la valeur par défaut, et lesquels des outils retirés devraient revenir seulement quand une tâche en a besoin.
Les correctifs ci-dessus sont petits et distincts. La compaction mérite d'être présentée du début à la fin, parce qu'elle montre la boucle à l'œuvre sur un seul problème, du diagnostic à la mise en production. La compaction est la façon dont Kiro résume une longue conversation quand elle atteint sa limite de contexte, afin qu'une nouvelle instance puisse poursuivre. Le diagramme ci-dessous montre comment nous avons choisi le correctif : 11 requêtes de résumé candidates (deux de Kiro, cinq issues de travaux externes, quatre de notre cru), comparées directement selon qu'un nouvel agent pouvait poursuivre à partir du seul résumé.
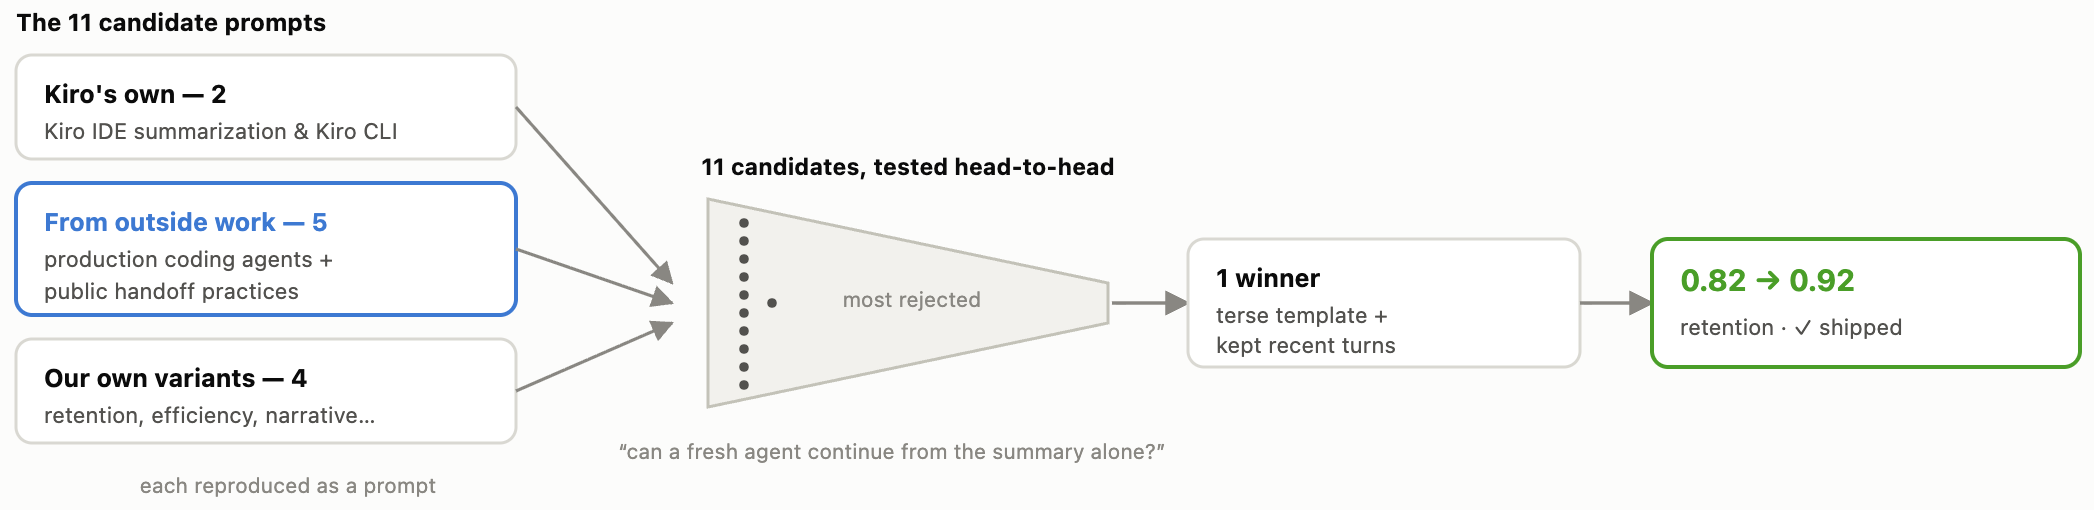
Après une compaction, Kiro pouvait abandonner sa tâche en cours et reprendre avec assurance une tâche beaucoup plus ancienne. L'ancienne conception ajoutait à la fin de chaque résumé une copie brute des messages antérieurs de l'utilisateur, du plus récent au plus ancien, de sorte que le résumé se terminait sur la question la plus ancienne, juste avant l'indication « reprends à partir du résumé ci-dessus ». Quand le message déclencheur était un simple « oui, fais ça », son contexte avait été résumé et effacé tandis que l'ancien fil survivait mot pour mot, si bien que l'agent rattachait la confirmation à la mauvaise demande.
kiro-trace a construit un test de référence à partir de vraies conversations internes ayant effectivement atteint la compaction, réparties en quatre tranches de taille allant jusqu'à environ 1,5 million de jetons. Il jugeait un résumé selon qu'une personne pouvait reprendre le travail à partir de celui-ci : il remettait chaque résumé candidat à un nouveau modèle, sans rien d'autre, et notait si celui-ci pouvait poursuivre. Le score couvrait quatre éléments : le résumé était-il exploitable, les chemins de fichiers y figuraient-ils, les décisions antérieures étaient-elles énoncées, et le fil restait-il cohérent.
kiro-trace a étudié comment divers agents en production et des pratiques publiques de passation effectuent la compaction, et a reconstruit chacun sous forme de requête, 11 en tout. Cinq provenaient de l'extérieur de notre propre code. Elles variaient beaucoup. Certaines étaient de longs modèles à plusieurs sections, d'autres des modèles fixes et concis, une prenait la forme d'un récit situation-action-résultat, et une autre était une étape qui décide quand effectuer la compaction.
Le correctif consistait à transporter moins de contexte d'une compaction à l'autre. Auparavant, Kiro conservait le résumé plus une liste brute des anciens messages de l'utilisateur, et c'est cette liste qui renvoyait l'agent vers la mauvaise tâche, si bien que la réordonner n'aurait pas suffi. Les requêtes externes nous ont montré l'éventail des conceptions auxquelles nous comparer, mais l'idée de retirer la liste est venue de notre propre diagnostic de la défaillance. Le correctif l'a retirée. Une compaction conserve maintenant un résumé court, rédigé selon un modèle fixe et concis et plafonné en taille, plus les tours les plus récents. Elle se termine par une indication de reprise statique qui ne nomme aucune tâche. Une session peut comporter plusieurs tâches en cours, et c'est en devinant l'une d'elles que l'agent faisait le mauvais rattachement. La rétention est passée de 0,82 à 0,92, et le correctif a été livré.
La boucle tient le même registre pour chaque candidat : la défaillance diagnostiquée, les éléments probants et la technique externe utilisés, l'unique élément modifié et le résultat mesuré. Aucune partie ne touche à la réponse propre à la tâche.
kiro-trace continue d'améliorer la boucle en même temps que Kiro. Il est parti de vérifications tirées de nos propres recherches et de notre code antérieurs, puis s'est enrichi à partir des erreurs. Chaque nouvelle vérification existe parce que la boucle ou l'équipe s'est fait tromper une fois d'une façon précise, et la plupart de ces erreurs portaient sur notre façon de mesurer, et non sur des bogues dans Kiro.
Dans un cas, un correctif valide a obtenu 0 sur 5 parce que sa sortie n'atteignait jamais l'évaluateur. Dans un autre, la configuration d'une tâche donnait à l'agent un moyen d'annuler ses propres erreurs, ce qui masquait un vrai bogue. Et une copie de travail périmée nous a un jour amenés à ouvrir une pull request pour quelque chose que le projet en amont avait corrigé la veille. Chacun de ces cas est devenu une vérification dans le code de la boucle.
Chaque correctif confirmé ajoute aussi une assertion déterministe sur son exécution à une suite de régression permanente, de sorte qu'une défaillance corrigée une fois ne peut pas revenir sans être détectée. Ces vérifications proviennent aujourd'hui d'une seule équipe. La prochaine étape consiste à les construire à partir des incidents et des tickets résolus d'Amazon, des leçons que l'entreprise a déjà payées, afin que les clients bénéficient d'un agent plus fiable et d'une meilleure expérience de développement.
kiro-trace trouve des problèmes dans les propres exécutions de Kiro, propose un changement à la fois et ne conserve un changement que lorsque des vérifications déterministes, puis un réviseur humain, l'acceptent. En une semaine, cela a produit sept correctifs fusionnés, et le travail sur la compaction a fait passer la rétention de 0,82 à 0,92.
- Séparez celui qui propose de celui qui juge. Placez l'acceptation et le rejet dans du code hors de portée du modèle.
- Décidez en fonction des écarts, et réexécutez un témoin chaque fois, parce qu'un nouveau modèle peut à lui seul faire bouger le score.
- « Aucun préjudice significatif » n'est pas la même chose qu'aucun préjudice, et les petits préjudices s'additionnent vite d'un changement à l'autre. Testez par rapport à une marge.
- Transformez chaque correctif confirmé en vérification de régression permanente sur le mécanisme qui a échoué, afin qu'elle couvre plus que le seul résultat.
- Essayez de retirer avant d'ajouter. Les gains les plus sûrs sont souvent des retraits, surtout à mesure que les modèles s'améliorent.
Pour les utilisateurs de Kiro, cela signifie moins d'appels gaspillés, une délégation plus judicieuse et un Kiro qui garde mieux le fil de ce qu'il faisait dans les longues conversations. Aucun changement issu de kiro-trace n'atteint les utilisateurs avant d'avoir franchi la barrière, avec des vérifications conçues pour le rejeter, puis une revue de code humaine. Nous jugeons d'abord une expérience sur un agent par ce qu'elle rejette. La plupart des candidats ne franchissent jamais la barrière, et ceux qui y parviennent sont les changements qui peuvent réellement améliorer l'expérience de développement.
Vous pouvez essayer Kiro dès aujourd'hui.