Comment nous avons construit une usine à logiciels avec Kiro Crew pour fusionner 1 000 PR en une semaine
La semaine dernière, nous trois qui construisons Kiro Crew à temps plein avons fusionné 1 000 pull requests en sept jours. Plus de 120 par jour, chacune est passée par la CI et la revue. Kiro Crew est principalement construit par ces trois ingénieurs à temps plein, avec près de 500 contributeurs communautaires enthousiastes.
Nous n'avions pas planifié ce nombre. Nous y sommes parvenus progressivement, à mesure que notre façon de construire davantage en parallèle atteignait de nouvelles limites au fil du temps. Chaque goulot d'étranglement nous a menés à une nouvelle façon de travailler qui permettait à une personne d'exécuter plus de sessions. Avec le recul, ces changements forment cinq étapes. La plus récente est ce que nous appelons maintenant le Crew Mode. Si vous utilisez des agents de programmation, vous êtes quelque part sur cette échelle, et l'étape où vous vous trouvez vous indique ce qui cédera ensuite.
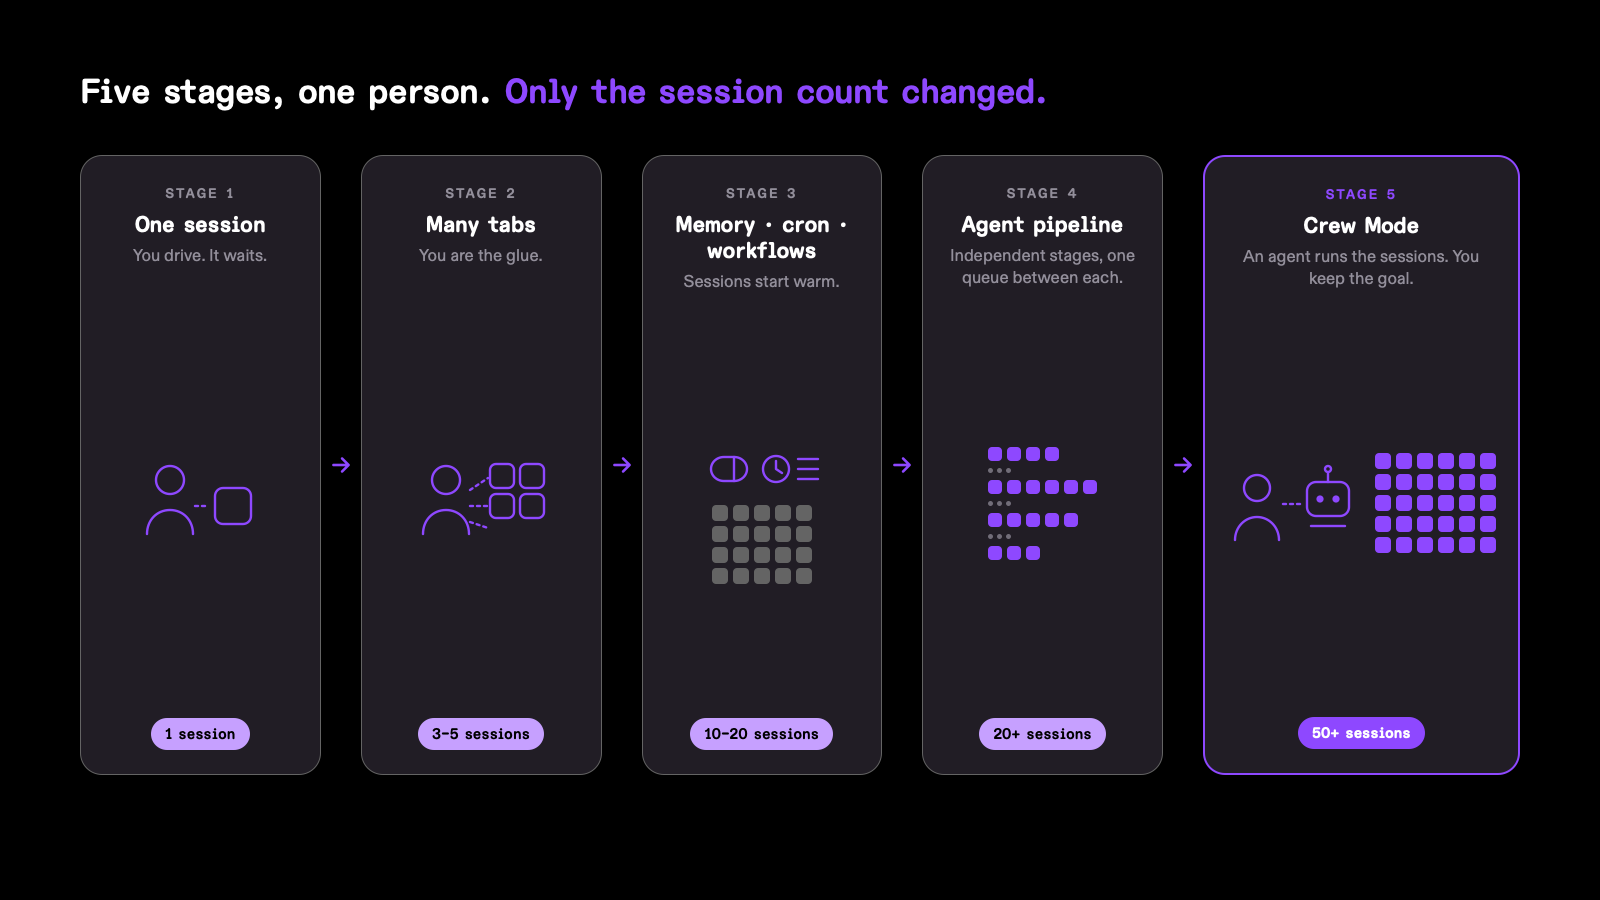
Étape 1 : une session, à la main. Un développeur, un agent, dans la CLI ou l'IDE. Cela fonctionne jusqu'à ce que vous remarquiez que votre attention est un fil unique. L'agent vous attend entre chaque étape, donc c'est vous le goulot d'étranglement.
Étape 2 : plusieurs sessions, à la main. Ouvrez un deuxième onglet, puis un troisième. Cela aide pendant un après-midi. Puis vous remarquez que vous réexpliquez le même projet dans chaque onglet et que vous gardez en tête laquelle fait quoi. Les sessions ne savent rien les unes des autres, donc vous êtes le seul à les relier.
Étape 3 : mémoire, tableau de bord, cron et flux de travail. C'est là que Kiro Crew a vraiment commencé. La mémoire a fait démarrer les sessions à chaud. Un tableau de bord a rendu plusieurs sessions faciles à suivre. Les boucles cron et de surveillance ont démarré des sessions sans aide humaine. Les flux de travail, fixes ou générés dynamiquement, ont enchaîné les étapes d'une tâche à travers plusieurs sessions, de sorte qu'un humain ne les parcourait pas manuellement étape par étape. Cela a permis à une personne de gérer environ 10 à 20 sessions actives, mais cela ne coordonnait pas tout ce travail. Les étapes des flux de travail s'exécutaient encore surtout en séquence. Le cron se réveillait selon un horaire, pas lorsqu'une autre session se terminait. Les sessions pouvaient couvrir différentes tâches ou différents projets, mais l'humain lisait toujours chaque mise à jour et choisissait ce qui nécessitait ensuite son attention.
Étape 4 : le pipeline d'agents. Pas celui de la CI, mais une chaîne de montage de sessions d'agents pour le travail général, où le triage, l'implémentation, la revue et la fusion s'exécutent chacun comme une étape indépendante avec ses propres sessions et ne se coordonnent qu'au moyen d'une file de messages. Aucune étape n'attend une autre. Chacune reprend l'élément suivant dès qu'il arrive dans sa file, de sorte que chaque étape est occupée en même temps sans qu'aucune ne connaisse les autres. Un flux de travail, en revanche, est une chaîne où l'étape trois attend l'étape deux. Le pipeline est ce qui a poussé une personne au-delà de 20 sessions simultanées. Ce qui reste, c'est que le pipeline est une forme fixe conçue par l'humain. Il ne peut pas replanifier lorsqu'un résultat invalide le plan, et un humain doit réviser le plan et rediriger le travail concerné.
Étape 5 : exploiter les sessions de façon agentive. Tout ce qui précède permet à une personne de gérer environ 20 sessions simultanées. Poussez vers 50, et l'intervention humaine devient la limite. Chaque session a encore besoin de quelqu'un pour définir son objectif, la démarrer, surveiller les problèmes, juger son résultat et décider de la suite. Accomplir ces cinq tâches sur 50 sessions devient un travail à temps plein.
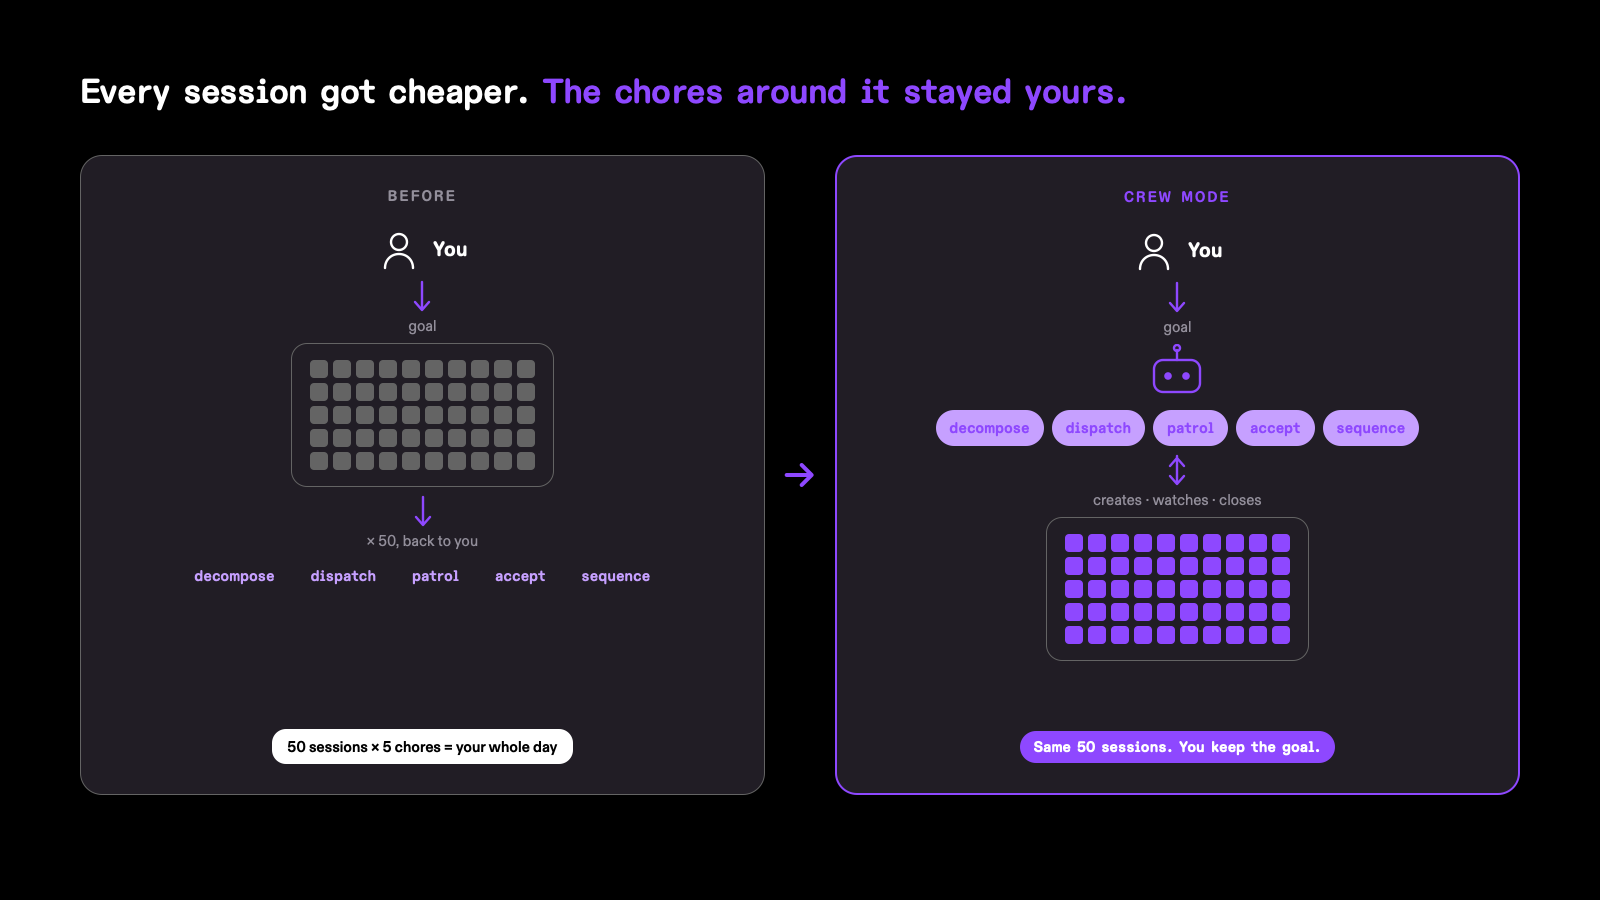
Le Crew Mode est un agent qui vit à l'extérieur de toute session individuelle et effectue lui-même ces travaux manuels, en réagissant aux résultats par-delà les frontières des sessions plutôt qu'en suivant une forme dessinée à l'avance. Les sessions deviennent une unité d'exécution qu'il crée, amorce, surveille et ferme. L'humain garde l'objectif. Les chiffres de la semaine dernière proviennent du pipeline travaillant de concert avec une version préliminaire du Crew Mode. Nous le construisons encore.
Où tout cela s'exécute-t-il? Partout où un processus peut s'exécuter. Une crew, c'est une passerelle plus les sessions qu'elle possède, et elle se moque de la machine sur laquelle elle se trouve. Aujourd'hui, nos crews s'exécutent sur des ordinateurs portables, sur des instances EC2, sur des postes de développement infonuagiques, et seront dans des conteneurs Fargate. J'exécute en fait six à dix machines à la fois, toutes reliées depuis un seul tableau de bord. Ensemble, elles gardent 30 à 50 sessions occupées en même temps : triage des problèmes, écriture de code pour les pull requests, revue et fusion. Les tâches d'agent qu'une crew délègue s'exécutent aussi sur GitHub Actions et CodeBuild.
Nous avons discuté tôt de la collaboration entre crews et l'avons classée sous « futur ». Le Crew Mode a ensuite rendu ce besoin concret. Son agent coordonnateur patrouille chaque session active pour trouver le travail bloqué, vérifie les résultats et met à jour le plan. À l'échelle de plus de 50 sessions, un seul agent coordonnateur devient un autre goulot d'étranglement. Il peut perdre le contexte ou manquer de l'expertise appropriée. Un super gestionnaire à lui seul ne règle pas ce problème. Plusieurs agents ont besoin de rôles, de portées et de façons de collaborer différents. L'un peut planifier, un autre exécuter et un autre réviser. Les crews peuvent alors échanger des résultats et acheminer le travail entre eux. Nous n'avons pu concevoir cela qu'après avoir vu un seul superviseur cesser de passer à l'échelle.
« Des agents qui exploitent des agents » est exactement le genre de formule qui invite au battage médiatique, alors soyons directs. Notre objectif est de bâtir des capacités auxquelles de vrais ingénieurs peuvent se fier. La majeure partie des développements actuels vise maintenant à rendre le Crew Mode sécuritaire et gouvernable. Nous n'essayons pas d'inventer une nouvelle solution sophistiquée. Quatre problèmes de gouvernance passent au centre lorsque plusieurs agents travaillent pour vous.
- Coordination entre agents. Qui a demandé quoi, qui possède quelle tâche, ce qui a été essayé et rejeté. Si cela ne vit que dans le contexte d'un modèle, cela disparaît à la prochaine compaction et personne ne peut reconstituer ce qui s'est passé. Cela doit être explicite et durable.
- Mémoire. Ce qui peut être mémorisé, par quel agent, pour quel projet, visible par qui. La correction d'un ingénieur ne devrait pas orienter en silence une session sur la base de code d'une autre équipe.
- Contrôle des permissions. Ce qu'un agent peut faire, dans quel dépôt, sur quel environnement, et ce qui nécessite un humain. Appliqué par l'hôte, pas demandé poliment dans une requête.
- Une trace pour chaque action. Chaque commande, modification de fichier, approbation et refus, enregistrés là où l'agent ne peut pas les modifier. La confiance ne vient pas d'un agent qui dit avoir fait la bonne chose, mais peut venir d'un historique qui permet d'en faire le suivi.
Ce sont les contrôles ordinaires dont toute entreprise a besoin lorsqu'un agent peut pousser du code en son nom : coordination des agents, frontières de mémoire claires, permissions au niveau de l'hôte et une piste d'audit que les agents ne peuvent pas altérer. Un plus grand nombre de sessions n'aide que lorsque les ingénieurs peuvent comprendre, contrôler et faire confiance à leur travail.
Le coût devient un problème distinct lorsque les flottes d'agents atteignent des centaines de sessions. Le travail principal des agents a déjà un prix. La coordination ajoute une autre couche : garder les sessions à chaud, vérifier l'état, acheminer les résultats et prendre en charge la distribution en éventail. À cette échelle, cette facture supplémentaire peut devenir un obstacle à l'adoption. Nous étudions la façon de la réduire avec des modèles moins coûteux pour la supervision de routine, des scripts pour les vérifications déterministes, des réveils à contexte minimal, la réutilisation des connaissances de session et une comptabilisation précise des coûts par tâche.
Les ingénieurs peuvent appliquer ces apprentissages immédiatement sans adopter notre outil. Commencez par votre étape actuelle et repérez ce qui ne passe plus à l'échelle. Faites la plus petite amélioration utile avant d'aller plus loin. Chaque étape apporte de la valeur tout en vous préparant à la suivante.
- Comptez vos sessions simultanées. Une seule signifie l'étape 1, quelques onglets l'étape 2, et ainsi de suite. Le nombre vous dit quel est le prochain problème, et ce n'est presque jamais celui qui semble le plus excitant.
- Passer de l'étape 1 à 2 est gratuit. Passer de l'étape 2 à 3 est celui qui rapporte. Avant d'ouvrir plus d'onglets, donnez de la mémoire à votre agent. La version la moins coûteuse est un fichier dans le dépôt que chaque session lit, contenant vos conventions et les corrections que vous répétez sans cesse. Quel que soit l'outil que vous utilisez, cette seule étape est ce qui transforme les sessions parallèles d'un fardeau en la valeur par défaut.
- Confiez une corvée récurrente à un horaire. Choisissez une tâche que vous faites à la main chaque jour, comme trier les nouveaux problèmes ou relancer une vérification instable, et confiez-la à une session qui démarre sur une minuterie. Vous en apprendrez davantage d'une seule session planifiée que de n'importe quelle quantité de lecture à leur sujet.
- Construisez un pipeline avant de construire un orchestrateur. Lorsque vos sessions font sans cesse les mêmes quelques types de travail, nommez les étapes et placez une file entre elles. Les étiquettes sur un problème GitHub sont une file parfaitement valable pour commencer. Un type de session par étiquette, chacun reprenant ce qui porte son étiquette.
- Ne commencez pas à l'étape 5. Notez les cinq responsabilités et remarquez laquelle occupe votre journée. Pour nous, c'était la patrouille entre plus de 50 sessions. C'est la responsabilité à automatiser en premier, et vous ne savez laquelle c'est qu'une fois que vous avez exécuté assez de sessions pour la ressentir.
- Mettez en place la gouvernance dès le premier jour, pas à l'échelle. La piste d'audit et le contrôle des permissions sont les deux que vous pouvez faire immédiatement. Enregistrez tout ce que font vos agents quelque part où ils ne peuvent pas le modifier, et décidez ce qu'ils peuvent faire au niveau de l'hôte plutôt que dans une requête. Les deux sont peu coûteux lorsque vous avez deux sessions et presque impossibles à ajouter après coup lorsque vous en avez cinquante.
Si vous voulez essayer la version que nous utilisons, Kiro Crew offre aujourd'hui la mémoire, le tableau de bord, le cron, les flux de travail et le pipeline, et le Crew Mode de base est disponible dans le dépôt en activant l'aperçu des fonctionnalités. Le moyen le plus rapide de commencer est de l'installer sur un ordinateur portable, de le pointer vers un dépôt et de lui confier une corvée planifiée. Déplacez-le vers une instance infonuagique une fois que vous voulez qu'il fonctionne pendant que vous dormez.
Aujourd'hui, l'humain confie encore à la crew un objectif concret, comme livrer cette fonctionnalité ou rendre ce dépôt vert. Avec le temps, cet objectif devrait devenir plus abstrait, et les crews devraient proposer du travail au lieu de l'attendre. Mais cela ne peut se produire qu'une fois que les capacités de gouvernance et de contrôle des coûts sont en place et entièrement testées. Une capacité qu'une entreprise ne peut ni contrôler, ni auditer, ni se permettre est une démo, pas un produit.
Kiro Crew est à code source ouvert. Le dépôt public contient le code, les documents d'architecture et les spécifications de fonctionnalités derrière tout ce qui se trouve dans ce billet : https://github.com/kirodotdev/KiroCrew. Si vous voulez bâtir votre propre usine à logiciels comme celle-ci, essayez Crew à kiro.dev/crew.