Garder une usine à logiciels stable à 1 000 PR par semaine
Dans notre dernier billet, nous avons décrit comment trois ingénieurs et une crew d'agents ont fusionné 1 000 pull requests en une semaine. La question qu'on nous a posée le plus souvent, c'est comment nous évitons que tout casse. Mais nous pensons qu'il y a une meilleure question à poser. Un humain peut-il être responsable de chaque PR qu'il a livrée, y compris du code qu'il n'a pas écrit et qu'il n'a pas lu ligne par ligne? Pourriez-vous même parler avec assurance de l'une de ces PR si un leader technique vous posait la question?
Un agent peut écrire une modification de code en quelques minutes, alors la vitesse est la partie facile. Maintenir un niveau de qualité élevé à cette vitesse est difficile, parce que nous devons savoir que chaque modification est correcte, sûre et digne d'être fusionnée sans qu'un humain en lise chaque ligne.
Avant l'IA, la confiance ne venait pas seulement du fait que quelqu'un lise et approuve chaque if/else lors de la revue. La revue manuelle était nécessaire, mais pas suffisante. Elle était suivie de nombreux autres tests, et généralement de quelqu'un qui exécutait la modification à la main dans un environnement réel ou simulé. C'est des tests que venait la confiance.
Mais les tests humains ne suffisent pas à eux seuls. Une personne ne peut essayer que quelques cas, généralement le scénario nominal ou les cas limites évidents. C'est pourquoi, sur un service en production que l'un de nos trois ingénieurs gérait auparavant, chaque modification passait quand même par des tests automatisés dans le pipeline de publication après des tests manuels minutieux. Cela montre que les humains s'appuyaient sur des bancs de tests automatisés pour obtenir une grande confiance, même avant l'IA.
Ainsi, « comment un humain peut-il être responsable du code écrit par l'IA? » devient une autre question. Comment construire des tests et des vérifications automatiques assez solides pour que nous leur fassions plus confiance qu'à notre propre lecture? Un humain ne peut pas lire chaque modification, mais un pipeline peut toutes les tester, chaque fois, de la même façon. C'est pourquoi, dans l'équipe Kiro Crew, nous consacrons environ 20 % de notre temps à l'infrastructure qui nous permet d'automatiser davantage.
Cela change aussi ce que « connaître une PR » veut dire. Si quelqu'un nous donne un numéro de PR, nous ne récitons pas le diff de mémoire. Nous demandons à notre crew et recevons en une minute un résumé en langage clair, ancré dans le code, dans des preuves de test comme des captures d'écran, des vidéos et des données, et dans le registre de revue. Le registre de revue est la trace que la CI (intégration continue) écrit sur chaque pull request : chaque constat d'un réviseur, la façon dont chacun a été corrigé ou a reçu une réponse appuyée par des preuves, chaque résultat de vérification et le verdict final de préparation. Il montre que chaque modification est passée par les mêmes revues, les mêmes tests et les mêmes barrières. C'est de ce registre que nous sommes responsables.
La qualité devient donc un problème de CI/CD et de tests. Nous avons fait passer la couverture de tests au-delà de 90 % et prévoyons d'atteindre 100 %, protégé la suite de tests contre les régressions, et ajouté des tests agentifs, où un agent pilote la vraie application comme le ferait un utilisateur.
La qualité a augmenté en cinq étapes, au rythme de notre vitesse de programmation. Nous n'avons pas planifié tout le système à l'avance. Chaque étape visait les deux mêmes objectifs, une meilleure qualité et plus d'automatisation, et résoudre un problème révélait généralement le suivant. Aucune des étapes n'est terminée, et nous améliorons encore chacune d'elles chaque semaine. Si vous faites travailler des agents de programmation sur une vraie base de code, vous frapperez probablement les mêmes murs, dans le même ordre.
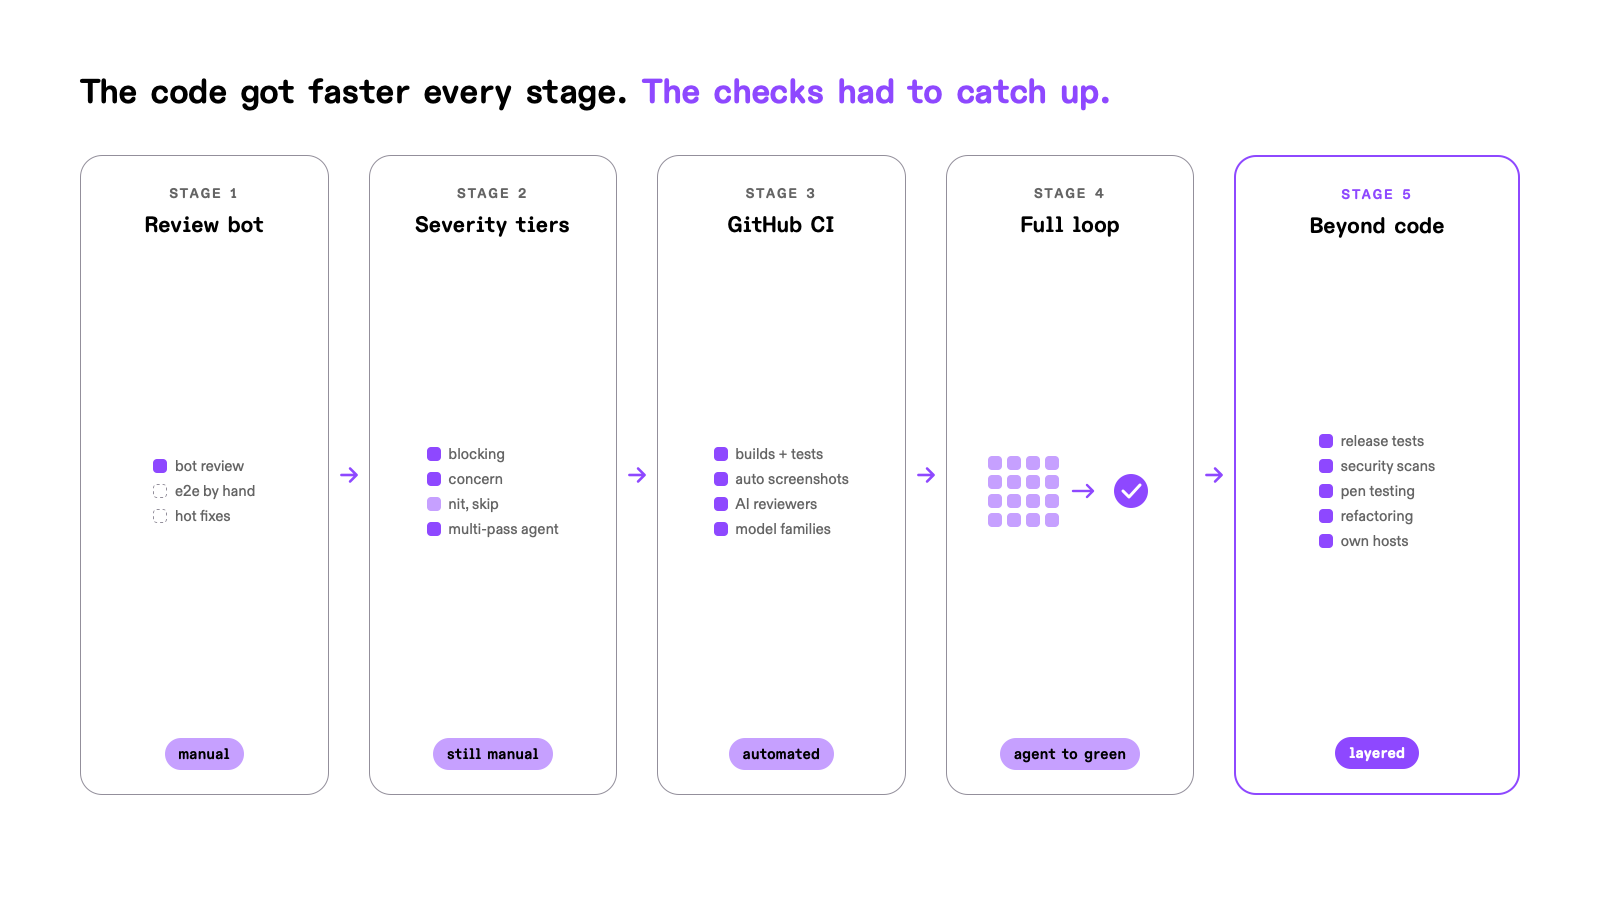
Au début de mars, l'équipe a mis en place un mécanisme de base de revue de code et a tenté de réviser chaque modification à la main, une approche qui a duré moins d'une journée. Kiro Crew n'était alors qu'un projet parallèle avec beaucoup moins de modifications, et c'était déjà trop pour une revue humaine. Cela nous a obligés à automatiser la revue.
Kiro Crew a démarré dans notre système interne de build et de revue, qui exécute un robot de revue automatisé sur chaque modification. Nous avons ajouté une règle stricte : chaque commentaire de l'IA, quelle que soit sa priorité, devait être résolu avant la fusion. La règle avait l'air d'une garantie de qualité, mais elle est devenue une source de friction, et trois problèmes sont vite apparus.
- Aucun vrai test de bout en bout. Le pipeline n'avait aucun test de bout en bout pour Kiro Crew et aucune utilisation réelle du produit, si bien qu'une modification pouvait casser l'application même après la résolution de tous les commentaires. Un humain devait tout tester à la main et joindre des captures d'écran comme preuve, et tout ce qui passait entre les mailles revenait sous forme de correctif urgent.
- Les commentaires arrivaient ronde après ronde. Vous corrigiez cinq commentaires, poussiez le code, et en receviez quatre nouveaux sur du code que vous n'aviez pas touché, puis trois de plus. Comme chaque commentaire devait être résolu, une petite modification pouvait demander une journée d'allers-retours. Pire, chaque correction ajoutait souvent du nouveau code, comme une vérification ou un chemin de code supplémentaire, qui attirait ses propres commentaires. Une petite correction pouvait devenir une modification bien plus grosse que prévu.
- Peu de contrôle sur le réviseur. Nous pouvions ajouter nos propres règles, mais nous ne pouvions pas voir si une règle s'était déclenchée, pourquoi, ou pourquoi elle avait raté quelque chose. Sans cette rétroaction, nous ne pouvions pas ajuster le réviseur aux problèmes que nous rencontrions sans cesse.
Ce que nous avons appris. Une règle stricte n'aide que si le réviseur fournit une rétroaction complète et ajustable. Les modifications doivent aussi être testées de bout en bout dans le vrai produit. Sans ces deux éléments, la revue s'est transformée en remous, et de vrais bogues atteignaient quand même les utilisateurs.
Nous avons d'abord classé les commentaires par niveau de gravité. Les constats bloquants et les vraies préoccupations doivent être corrigés dans la même PR. Les commentaires mineurs et les détails de style deviennent des tickets de suivi pour de futures PR. Cela garde chaque PR petite et concentre la revue sur la modification à l'étude.
Le classement par niveaux peut sembler abaisser la barre, et il n'arrête pas la boucle où chaque correction attire de nouveaux commentaires. Nous avons donc aussi ajouté notre propre agent de revue à côté du robot existant. Il analyse la modification en plusieurs passes, chacune ayant pour consigne d'ignorer ce que les passes précédentes ont trouvé. Le but est de faire ressortir tous les vrais commentaires en une seule ronde, pour qu'un contributeur corrige une fois au lieu de plusieurs. La lecture attentive de ces revues pendant cette étape nous a aussi surpris. Les réviseurs IA trouvaient des problèmes plus profonds que ce qu'un lecteur humain aurait habituellement repéré. Ce constat nous a aussi amenés à renoncer à réviser le code manuellement ligne par ligne.
Le réviseur IA supplémentaire a aidé, mais un humain pilotait encore chaque ronde de correction. Crew, exécuté en local, peut faire la correction elle-même à partir des commentaires de revue, mais un humain doit encore pousser le code mis à jour pour la revue en ligne, puis attendre un certain temps pour rapporter les nouveaux commentaires à Crew en local pour la correction suivante. Ce processus peut prendre plusieurs rondes et beaucoup de temps, si bien que certains contributeurs ont cessé de contribuer à cause de ces étapes fastidieuses après quelques boucles. Pour combler cet écart, nous avons livré des Skills intégrés qui permettent à chacun d'exécuter les tests et la même revue IA en local, afin d'obtenir les commentaires requis et de faire la correction rapidement sur sa machine avant d'envoyer la PR.
Ce que nous avons appris. Une revue stricte aide à bâtir de bons logiciels, mais une longue boucle pilotée par un humain peut faire fuir les contributeurs. L'automatisation est la solution, et il nous manquait encore la CI pour l'exécuter.
Le passage de Kiro Crew à GitHub nous a donné un solide soutien CI/CD pour un projet à code source ouvert. Chaque pull request obtient maintenant automatiquement des builds, des tests unitaires et des tests de bout en bout. Le pod de test intégré de Kiro Crew exécute le code mis à jour dans un environnement isolé, capture des captures d'écran et des vidéos des fonctionnalités concernées et les joint à la pull request. Un travail qui gobait l'après-midi d'un ingénieur s'exécute maintenant sur chaque modification. Avec une CI automatique, nous pouvions nous permettre d'ajouter des vérifications bien plus riches.
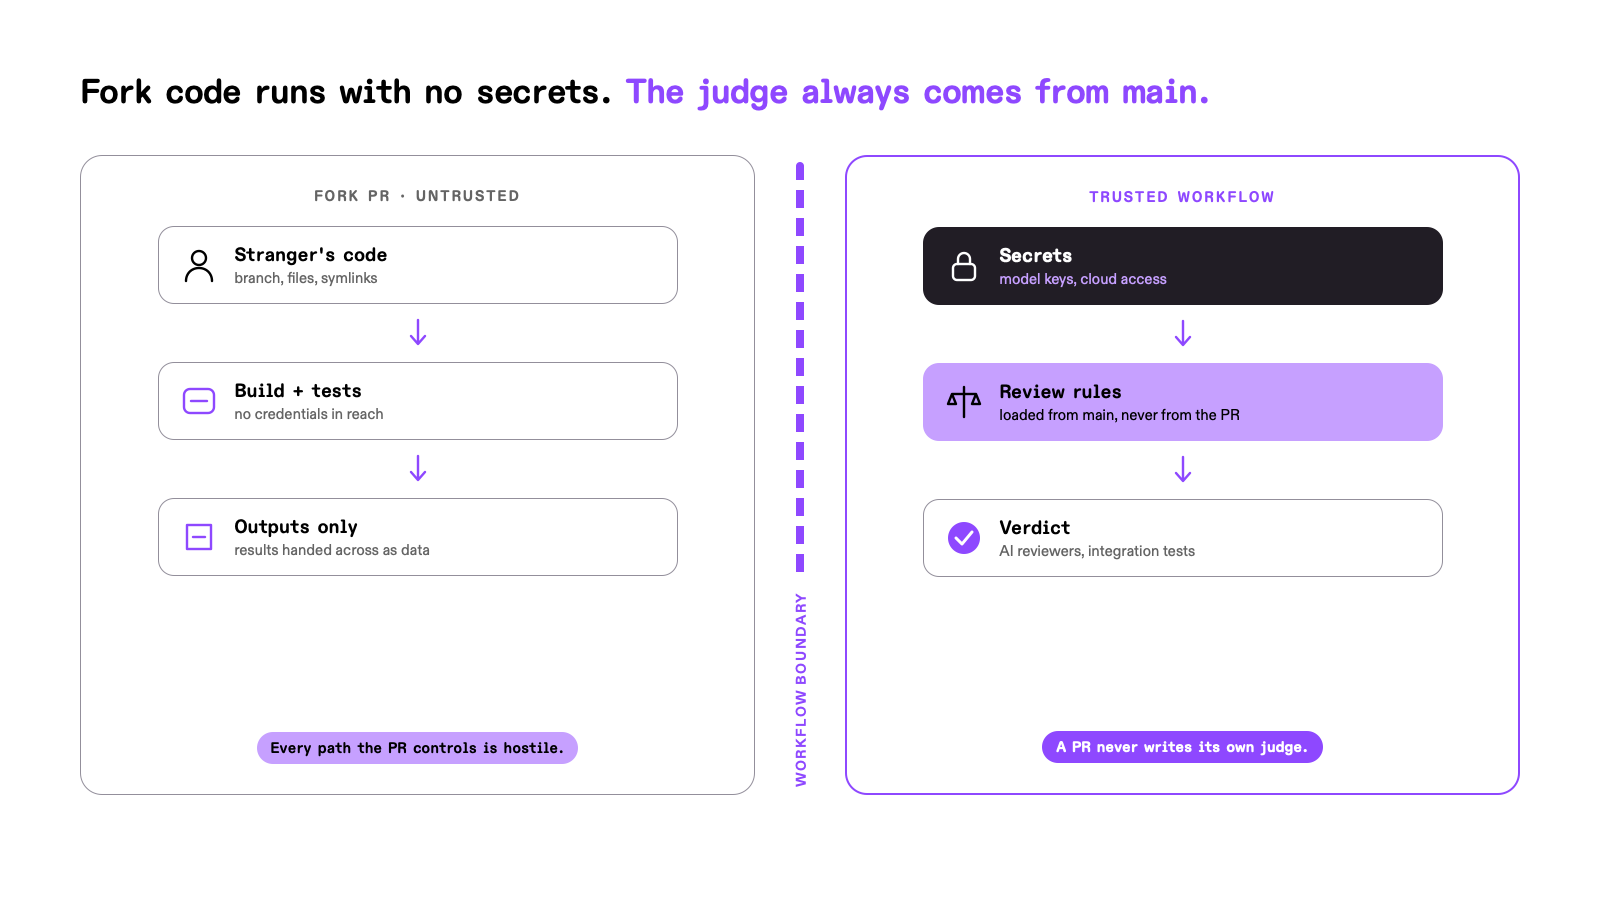
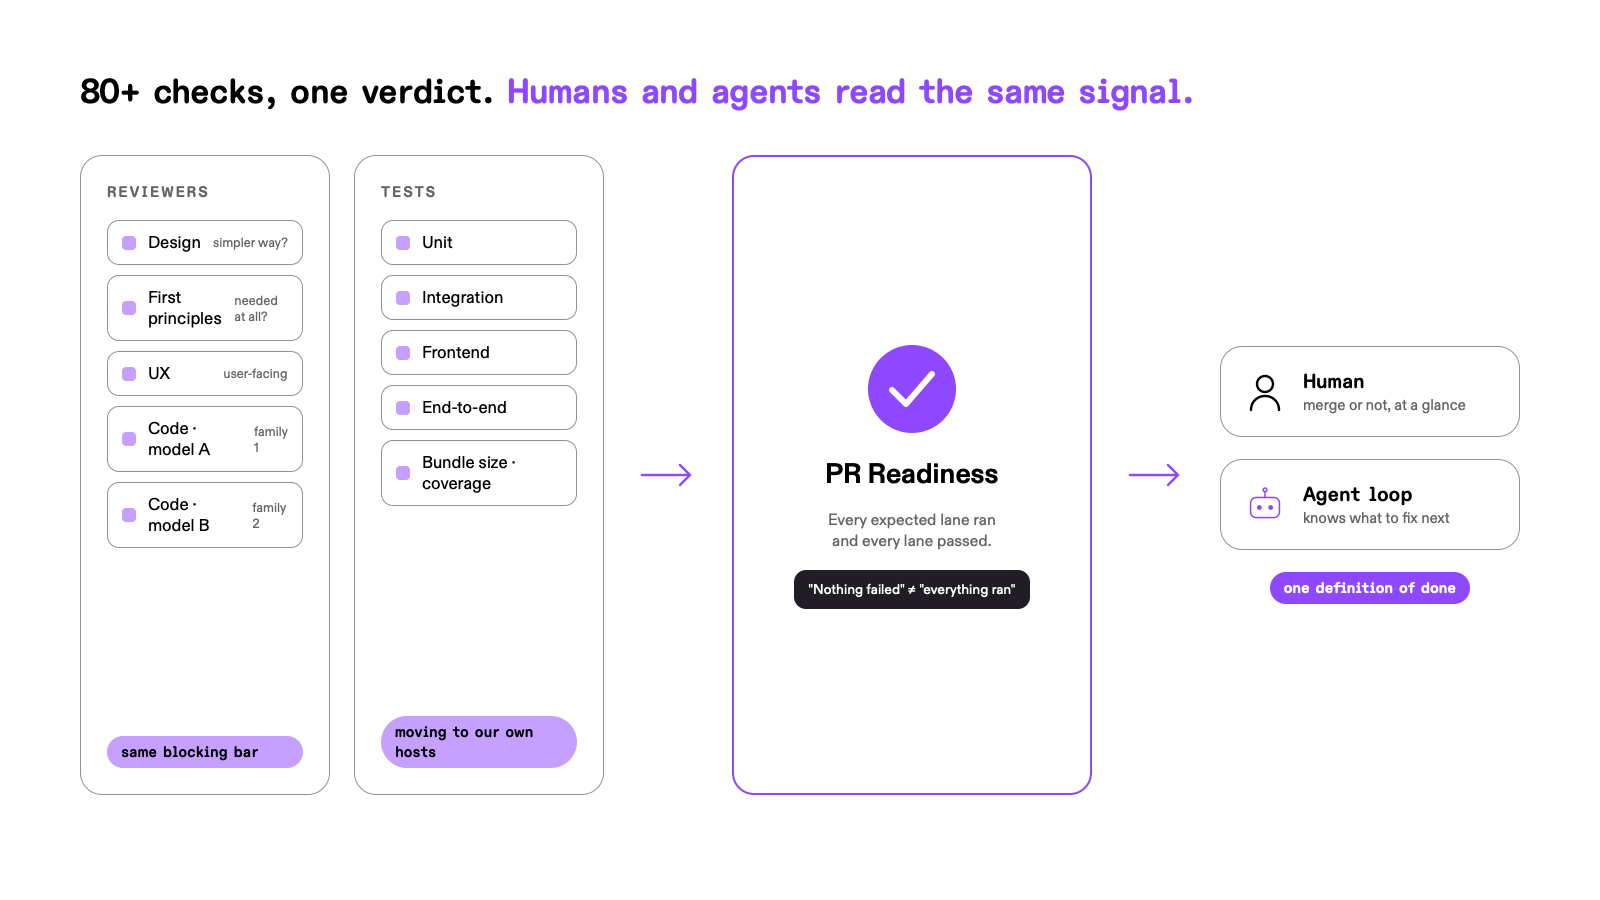
Des réviseurs avec des tâches différentes. Un seul réviseur IA qui regarde tout ne peut pas creuser assez loin, alors nous avons réparti la revue par rôle. Un réviseur de conception vérifie si la modification cadre avec l'architecture, et s'il existe une solution beaucoup plus simple. Un réviseur des premiers principes vérifie si la modification corrige la cause profonde, et si les utilisateurs en ont vraiment besoin. Un réviseur UX évalue les modifications visibles par les utilisateurs. Le code est aussi analysé par des réviseurs issus de familles de modèles différentes, parce qu'un modèle qui révise le code de sa propre famille en partage les angles morts.
Un ensemble complet de tests. Les tests unitaires, les tests d'intégration, les tests d'interface, l'empaquetage pour ordinateur de bureau, les budgets de taille de bundle, les seuils de couverture et les tests de bout en bout détectent chacun une catégorie de défaillance différente. L'intégration est l'endroit où les agents se trompent le plus souvent, parce que chaque modification semble correcte isolément.
Une seule définition de « bloquant ». Un constat bloquant exige un emplacement précis, une preuve citée, un déclencheur et une conséquence. Si un réviseur ne peut pas dire ce qui casse et comment, le constat est consultatif. Plus précisément, les préoccupations de conception sont consultatives, à moins qu'elles ne décrivent une porte à sens unique, un choix que nous ne pourrons pas défaire plus tard. Pour un choix réversible, nous acceptons le risque, parce que refactoriser plus tard est facile aussi.
Ce que nous avons appris. L'automatisation permet de vérifier bien plus que ce que des personnes pourraient jamais faire. Mais plus de vérifications voulait dire plus de résultats qu'un humain devait lire et traiter, et l'humain est devenu le goulot d'étranglement.
À l'étape 3, un humain pilotait encore chaque ronde de correction du code. À chaque ronde, un ingénieur vérifie quelles étapes de la CI ont échoué, copie les détails des échecs de la CI, y compris les suggestions de la revue IA, dans Crew et lui demande de corriger les problèmes. Nous ne traitons pas une suggestion de l'IA comme une chose à laquelle nous devons nous fier, mais comme un intrant pour une analyse locale plus approfondie. Kiro Crew la vérifie par rapport au code, exécute les tests, et la CI vérifie de nouveau la correction à la ronde suivante. Comparé à tout ce travail supplémentaire derrière chaque correction, un humain qui pilotait chaque décision n'ajoutait pas grand-chose.
Nous avons donc livré un Skill intégré, prepare-pr, qui pilote la boucle jusqu'à ce que la pull request soit au vert. Il lui fallait un signal clair à lire, parce qu'il est coûteux d'analyser plus de 80 vérifications pour chaque pull request. Nous avons ajouté une seule vérification PR Readiness qui regroupe tous les résultats des actions CI/CD en un seul verdict. Elle doit signifier que chaque action CI/CD attendue s'est exécutée et a réussi, pas seulement que rien n'est encore rouge, parce que sur une nouvelle pull request, « aucune vérification en échec » et « rien ne s'est encore exécuté » se ressemblent.
prepare-pr lit ce verdict, récupère les actions CI/CD en échec et les constats de revue, corrige ce qui est réel, répond avec des preuves à ce qui ne l'est pas, puis pousse de nouveau. La CI vérifie la nouvelle révision, et la boucle lit le résultat. Quand le verdict est au vert, le Skill s'arrête, et le même verdict indique à un humain que la pull request est prête. L'humain et l'agent partagent une seule définition de « terminé ».
Avec des agents qui amènent automatiquement les pull requests au vert, cliquer sur le bouton d'approbation est devenu chronophage quand il y a beaucoup de PR. Pour automatiser cette étape, nous classons d'abord chaque pull request selon un niveau. Les PR de niveau simple sont approuvées et fusionnées automatiquement, et pour les autres, l'IA rédige des suggestions de revue pour l'humain. Pour accélérer la revue humaine, l'agent rédige la description de la pull request et la réécrit chaque fois pour qu'elle corresponde aux modifications de code réelles. Il utilise un gabarit fixe, un langage facile à comprendre, et même des diagrammes liés à la modification, pour qu'un humain puisse comprendre la pull request en quelques secondes. Une vérification de la CI s'assure aussi que la description correspond strictement au code.
Ce que nous avons appris. Une fois que les vérifications et les corrections partagent un seul signal, l'agent peut faire tourner la boucle, et les humains ne prennent que les décisions qui exigent leur intervention. La boucle crée toutefois ses propres problèmes, surtout la suringénierie et les correctifs de sécurité qui vont trop loin. Nous abordons les deux après la dernière étape.
Nos revues de code laissent encore passer certains bogues, alors la fusion du code n'est pas la dernière étape. La qualité globale ne dépend généralement pas seulement du code d'une seule pull request.
Avant chaque publication, des tests supplémentaires s'exécutent sur le produit construit, y compris des tests agentifs. Un agent installe et pilote la vraie application à travers les parcours essentiels, comme démarrer une session, exécuter une tâche, utiliser la mémoire et planifier une tâche. Les tests unitaires vérifient qu'une fonctionnalité précise fonctionne, et les tests agentifs vérifient que le parcours essentiel du produit fait toujours ce que les utilisateurs attendent.
Le code fusionné continue d'être vérifié en plusieurs couches, pour qu'un problème qui échappe à une couche ne vive pas longtemps.
- Des vérifications de conformité toutes les heures sur le code fusionné, pour savoir s'il est passé par la revue requise et s'il respecte les règles de sécurité essentielles.
- Des analyses quotidiennes par un agent de sécurité interne, appliquées à notre base de code à code source ouvert comme à d'autres services internes.
- Un robot de sécurité toujours actif qui effectue de vraies opérations sur l'outil et tente de percer les garde-fous de sécurité pour trouver les problèmes à corriger.
- Une boîte de réception de sécurité gérée pour recevoir les signalements externes, avec un délai de traitement rapide.
Les modifications rapides laissent des aspérités, comme de gros fichiers, de la logique dupliquée et du code mort. Nous refactorisons selon un calendrier régulier pour que la base de code reste facile à modifier, autant pour les humains que pour les agents. Cette refactorisation périodique nous permet aussi d'utiliser les modèles les plus récents pour écrire un meilleur code.
Avec des dizaines de vérifications automatiques sur chaque pull request et une centaine de pull requests par jour, nous avons atteint les limites de débit de GitHub et nos limites de ressources. Pour atténuer le problème, nous avons réparti les actions de la CI en groupes, puis les exécutons groupe par groupe. Par exemple, une barrière rapide exécute maintenant d'abord les vérifications peu coûteuses, et les vérifications lentes ne démarrent qu'une fois la barrière rapide franchie. Nous avons aussi déplacé la revue vers AWS CodeCommit et quelques charges de travail de test vers nos propres hôtes, pour que ce soit notre matériel qui fixe la limite.
Quand la programmation est facile, dire oui à une fonctionnalité l'est aussi. Mais trop de fonctionnalités fusionnées à la fois peuvent facilement mener à des conflits implicites et inattendus. Un code bon marché peut aussi attirer l'équipe vers des solutions techniques sophistiquées au lieu de se concentrer sur la bonne façon de construire. Pour régler ce problème, chaque demande de fonctionnalité est maintenant classée avant que quiconque la construise. Une modification simple peut être construite directement, une fonctionnalité de niveau moyen exige une conception d'une page, et une fonctionnalité complexe exige une revue par toute l'équipe.
Ce que nous avons appris. Réussir chaque vérification avant la fusion n'est pas la même chose que rester en bonne santé avec le temps. La qualité exige des vérifications qui continuent de s'exécuter sur le code du produit. Elle exige aussi un processus qui décide quelles fonctionnalités sont construites, parce que les bogues les plus coûteux sont ceux des fonctionnalités dont les utilisateurs n'ont jamais besoin.
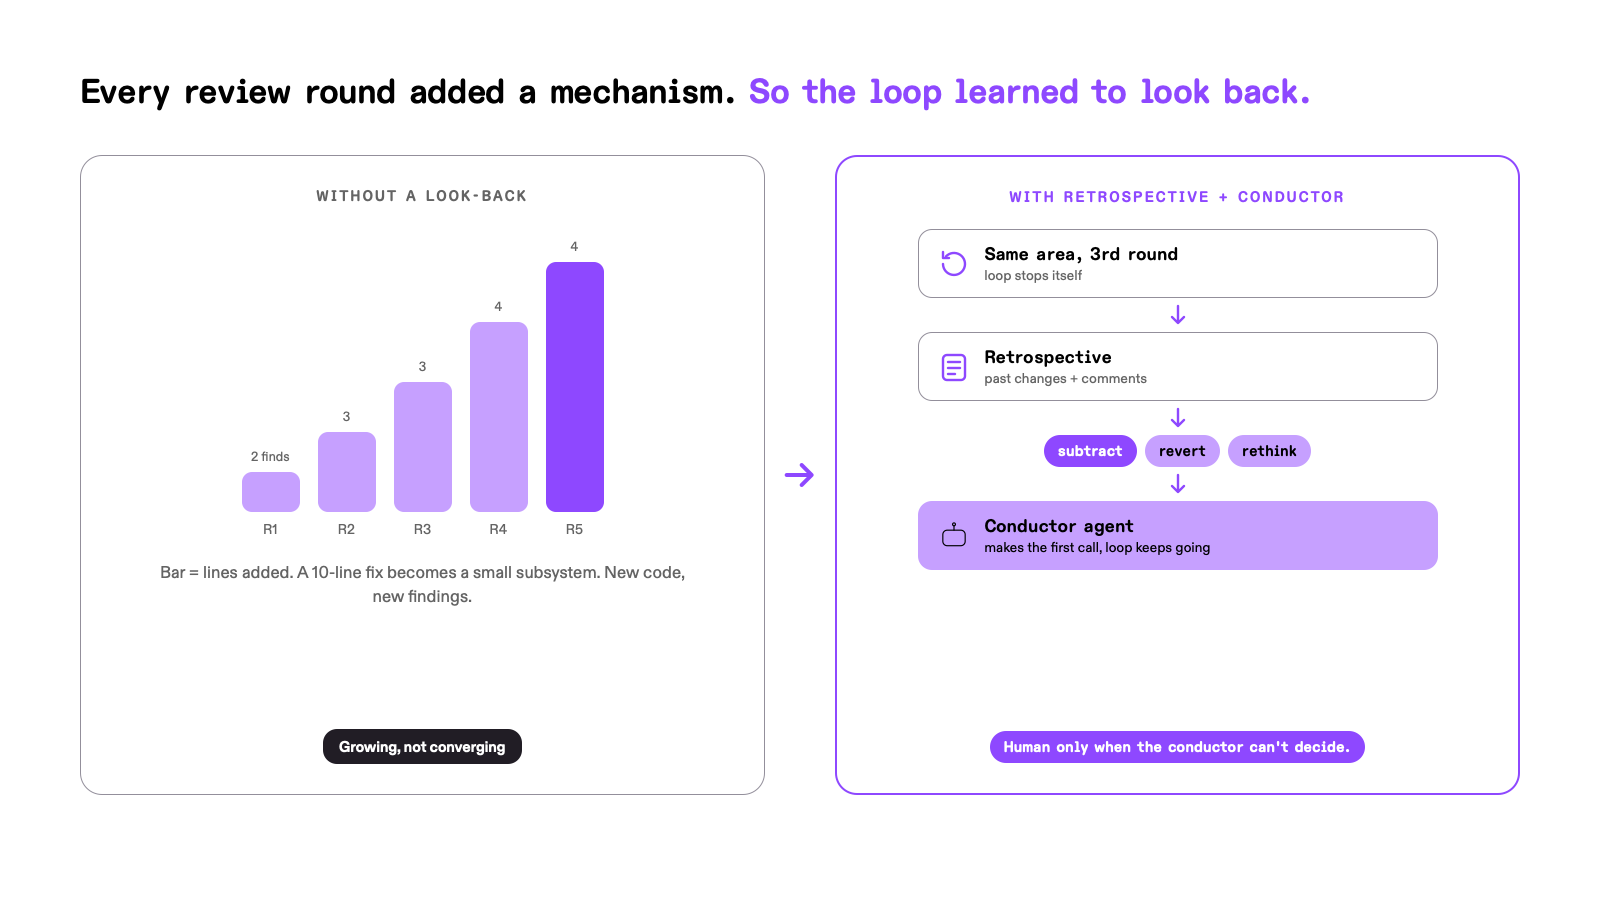
C'est la plus grande source de gaspillage une fois que la boucle de revue et de correction tourne seule. Un réviseur signale un cas limite, et l'agent ajoute un mécanisme. La revue suivante signale un cas limite dans le nouveau mécanisme, et l'agent en ajoute un autre. Après cinq rondes, une correction de dix lignes est devenue un petit sous-système dont personne n'avait besoin.
Nous avons donc ajouté des rétrospectives, à la fois dans le Skill prepare-pr et dans la CI. Après plusieurs rondes sur la même zone, la boucle revient sur son propre historique : ce qui a changé, ce que les réviseurs ont dit, et si la modification grossit au lieu de converger. Elle recommande ensuite un arrêt, un retour en arrière ou une approche plus simple. La première mesure consiste généralement à retirer les mécanismes qui ne sont plus nécessaires, et les constats restants diminuent eux aussi.
Nous vérifions aussi la proportionnalité de chaque correction suggérée. Un constat peut être juste et demander quand même trop. La correction doit être la modification de code directe qui règle le problème décrit dans la description de la pull request, et tout ce qui est plus gros devient un suivi. La seule exception est un plantage atteignable, une faille de sécurité ou une perte de données, qui sont toujours corrigés.
Mais la rétrospective a aussi créé un nouveau problème : elle exige des actions humaines pour décider des changements de stratégie de programmation à apporter, même si les recommandations de stratégie sont généralement claires. Demander davantage l'avis des humains peut sembler la meilleure façon d'obtenir un code de meilleure qualité, mais chaque question arrête l'automatisation. Pour régler le problème, un deuxième agent, le conductor, lit la recommandation de la rétrospective et prend lui-même la première décision. L'humain n'est sollicité que lorsque le conductor ne peut pas trancher.
L'IA est zélée en matière de sécurité. À partir d'un seul vrai constat, elle ajoutera trois couches de défense, un nouvel indicateur de configuration et une étape de validation qui ne s'exécute jamais. Chaque ajout est du nouveau code qui peut casser, et une nouvelle surface que la prochaine ronde de revue pourra signaler. Voici deux cas intéressants détectés pendant notre développement.
- Un bac à sable qui bloque le travail normal. Chaque ronde de revue resserrait un peu plus le bac à sable de l'agent. Chaque étape semblait raisonnable isolément, mais ensemble, elles faisaient échouer des tâches ordinaires, comme lancer un build ou lire un fichier du projet. Le produit était plus sûr sur papier, mais inutilisable en pratique.
- Se protéger d'un attaquant qui a déjà gagné. Une suggestion de sécurité classique consiste à copier un exécutable dans son propre dossier et à le verrouiller, pour qu'un attaquant présent sur la machine ne puisse pas le remplacer. Cette protection ajoute de la copie, des vérifications d'autorisations et des chemins de mise à jour qui peuvent chacun casser, et protège contre un cas extrêmement rare.
Nos correctifs de sécurité suivent donc une règle simple : corriger le problème réel, atteignable par l'utilisateur, avec les plus petites modifications de code possible.
Voici des suggestions qui ont fonctionné pour nous, mais chaque base de code est différente, alors adaptez-les pour qu'elles fonctionnent avec votre produit.
- Classez vos commentaires de revue par niveau. « Résoudre chaque commentaire » semble rigoureux, mais produit souvent du remous.
- Demandez tous les commentaires en une seule ronde. Un réviseur plus lent mais complet coûte moins cher qu'un réviseur qui distille ses constats au fil des rondes.
- Répartissez les réviseurs par rôle et par modèle. Des questions et des familles de modèles différentes détectent des problèmes différents.
- Condensez vos vérifications en un seul indicateur de préparation qui signifie « tout s'est exécuté et a réussi », et non « rien n'a encore échoué ».
- Testez le produit entier, pas seulement ses parties, avec au moins une étape qui pilote de vrais parcours avant la publication.
- Intégrez une rétrospective à votre boucle d'agents, et laissez un deuxième agent prendre la première décision pour que la pause n'exige pas toujours un humain.
- Gardez des correctifs de sécurité raisonnables. Utilisez des vérifications strictes pour révéler les vrais problèmes, mais faites des corrections petites et directes.
Kiro Crew est à code source ouvert. Les flux de travail, les requêtes de revue et le Skill prepare-pr décrits ici se trouvent tous dans le dépôt sur GitHub. Essayez Crew pour les voir à l'œuvre.